KI on premise – Teil 2: Praxis


Alle sensiblen Daten in eine KI-Wissensdatenbank einspeisen, die Ihre Fragen beantwortet? Kein Problem – solange sie im eigenen Haus läuft.
opensight.ch - roman hüsler
LLMs sind der letzte Schrei, ein grosser Schritt in der Digitalisierung und eine disruptive Technologie. Nicht ohne Grund fragen sich viele Unternehmen, wie sie diese Technologie im eigenen Betrieb nutzen können. Sensible Unternehmensdaten lassen sich meist nicht einfach zur Auswertung an eine Cloud-KI wie ChatGPT schicken. Deshalb fragen sich Unternehmen oft, wie sich KI-Lösungen intern und sicher einsetzen lassen.
KI lässt sich für die unterschiedlichsten Aufgaben einsetzen. Heute geht es in diesem Beitrag aber nicht um LLMs (lassen Sie es uns wissen, falls Sie sich dafür interessieren), sondern um ein verwandtes Gebiet der KI: die Verarbeitung natürlicher Sprache (Natural Language Processing, NLP) und den Aufbau einer «KI-gestützten Wissensdatenbank on premise». Sie können Ihre lokale Wissensdatenbank (etwa Confluence) anbinden und daraus eine KI-Maschine für Fragen und Antworten bauen.
Heute schauen wir uns Weaviate an: eine KI-gestützte Vektorsuchmaschine, die mit vortrainierten Sprachmodellen arbeitet und sich intern bzw. on premise betreiben lässt.
opensight.ch - roman hüsler
Wie viele IT-Techniker eigne auch ich mir gerade Wissen auf diesem Gebiet an. Ich nehme an, dass es vielen Leserinnen und Lesern dieses Blogs ähnlich geht und sie so auf diesen Beitrag gestossen sind. Sie müssen also kein KI-Spezialist sein, um diesem Beitrag folgen zu können.
Inhalt
Das grosse Ziel: KI on premise
Zuerst legen wir das Ziel dieser Blogserie fest. Das wollen wir erreichen:
- KI on premise
Eine KI, die lokal on premise läuft. - Wissensdatenbank
Sie soll mit Textdaten arbeiten können (also mit einer Wissensdatenbank). - Frage, Antwort
Ich möchte eine Frage stellen können (deren Antwort in der Wissensdatenbank steht).
Das System soll den passenden Artikel bzw. die Antwort auf die Frage finden. - API-Integration
Das System soll eine API haben, damit es sich einfach mit meinen anderen Systemen verbinden lässt.
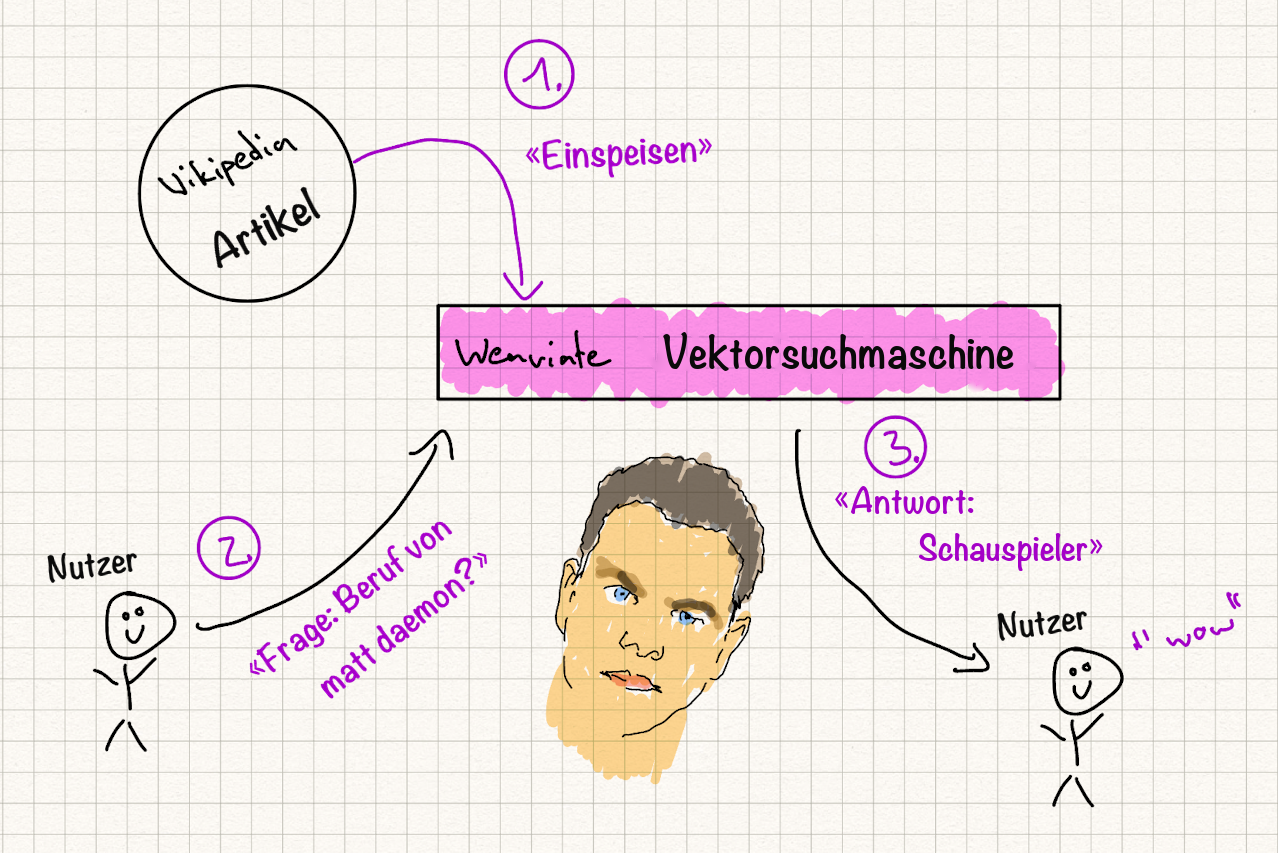
Dazu speisen wir einige Wikipedia-Artikel ein und stellen dann Fragen:
Kubernetes-Deployment
Ich möchte Weaviate auf meinem Testserver (on premise) betreiben, also auf einem Node in meinem Kubernetes-Cluster. Vor dem Deployment sind einige wichtige Punkte zu beachten.
Falls Sie sich einen Beitrag dazu wünschen, wie man im eigenen Haus einen Kubernetes-Cluster aufsetzt, um Workloads zu betreiben und zu testen, lassen Sie es uns wissen.
Speicherplatz
Weil vortrainierte Sprachmodelle viel Speicher brauchen, habe ich den Speicherplatz eines dafür vorgesehenen Kubernetes-Nodes vergrössert. Mit Node Taints habe ich sichergestellt, dass Weaviate auf genau diesem speziell konfigurierten Node deployt wird. Es gibt zwei grosse Komponenten: das Image des Sentence Transformers und das QnA-Modell, jeweils zwischen 5 und 10 GB gross.

Grafikkarte (GPU)
GPUs können die Leistung von Machine-Learning-Modellen deutlich steigern, potenziell um bis zum Zehnfachen. Leider hat unser Kubernetes-Node keine GPU, sodass wir für die Tests mit reinen CPU-Ressourcen auskommen müssen.
Für das Deployment setzen wir auf ArgoCD und eine Kustomization-Konfiguration, die die Deployments im Kubernetes-Cluster verwaltet. Unten finden Sie das Deployment-Chart als Referenz.

Das Kubernetes-StatefulSet von Weaviate wurde sauber deployt, und wir sehen einen Pod mit drei Containern: Weaviate, den Text-zu-Vektor-Transformer und den QnA-Transformer.
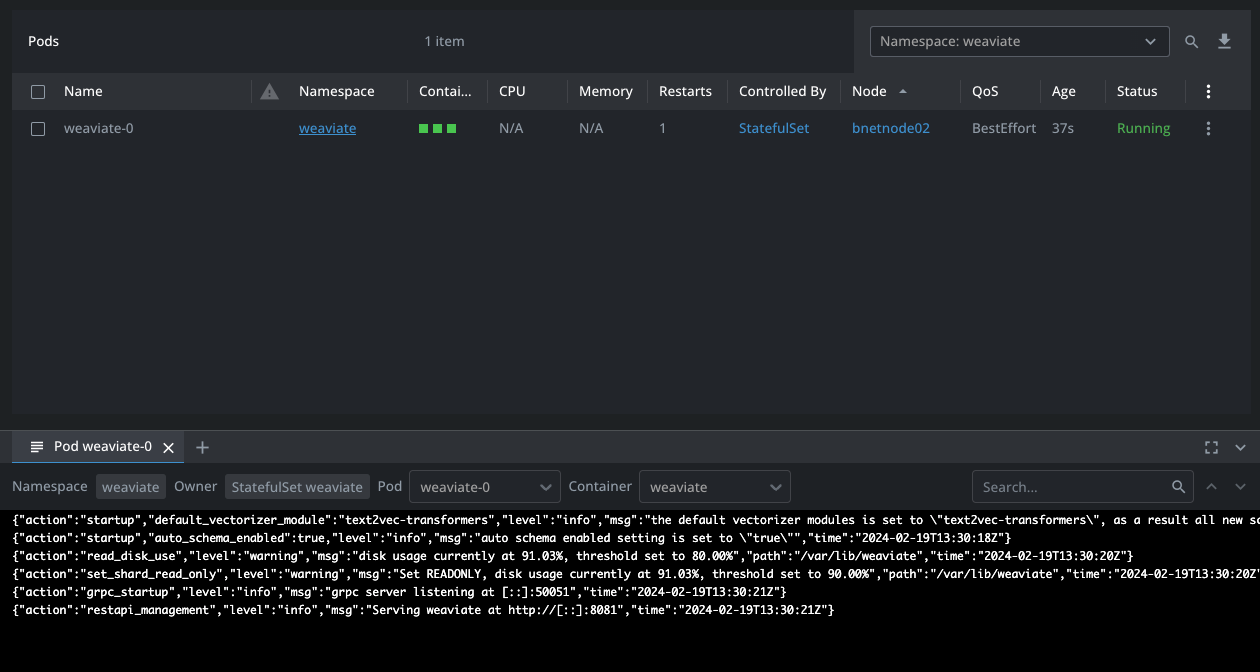
Damit ist Weaviate einsatzbereit, und wir können mit den Tests beginnen.
Schema anlegen
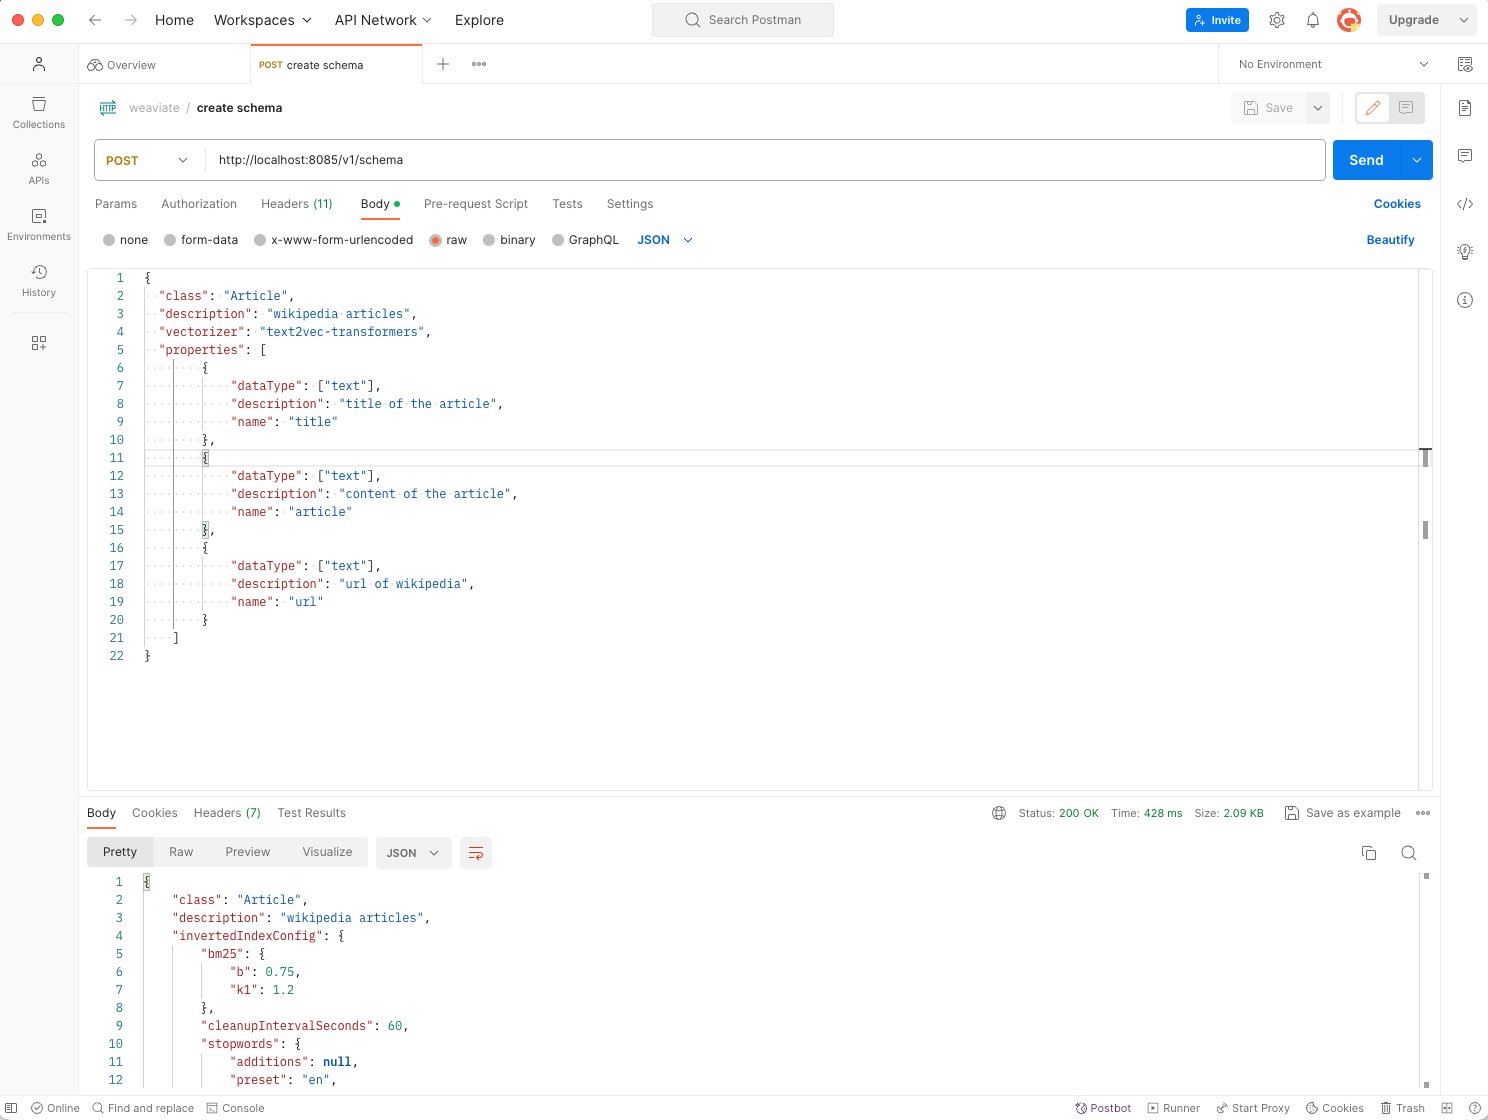
Beim Durchsehen der Dokumentation und der Quick-Start-Anleitungen von Weaviate (Link – Weaviate Quick Start Guide) habe ich festgestellt, dass der erste Schritt darin besteht, ein «Schema» anzulegen. Unser Ziel ist eine Wissensdatenbank mit Wikipedia-Artikeln als Testdaten. Dafür habe ich Port 8085 des Weaviate-Pods auf meinen lokalen Rechner weitergeleitet. Mit Postman (http://localhost:8085/v1/schema) habe ich dann ein einfaches Schema mit drei Properties angelegt.
- title
Titel des Wikipedia-Artikels - article
Inhalt des Wikipedia-Artikels - url
URL des Wikipedia-Artikels
Daten einspeisen
Um Weaviate zu testen, habe ich Daten bzw. Artikel aus Wikipedia importiert. Ein aussagekräftiges Testszenario: einen Artikel über «Matt Damon» hochladen und anschliessend nach seinem Beruf fragen: «what is the profession of matt daemon?». Dieser Test ist besonders aussagekräftig, weil im Wikipedia-Artikel über «Matt Damon» der Begriff «profession» (Beruf) gar nicht vorkommt (Stand zum Zeitpunkt des Schreibens).
Mit der Funktion «Zufälliger Artikel» von Wikipedia habe ich Artikel für die Indexierung ausgewählt. Ihren Text habe ich über die Funktion «Bearbeiten» kopiert und auf diese Weise rund 60 Artikel indexiert.
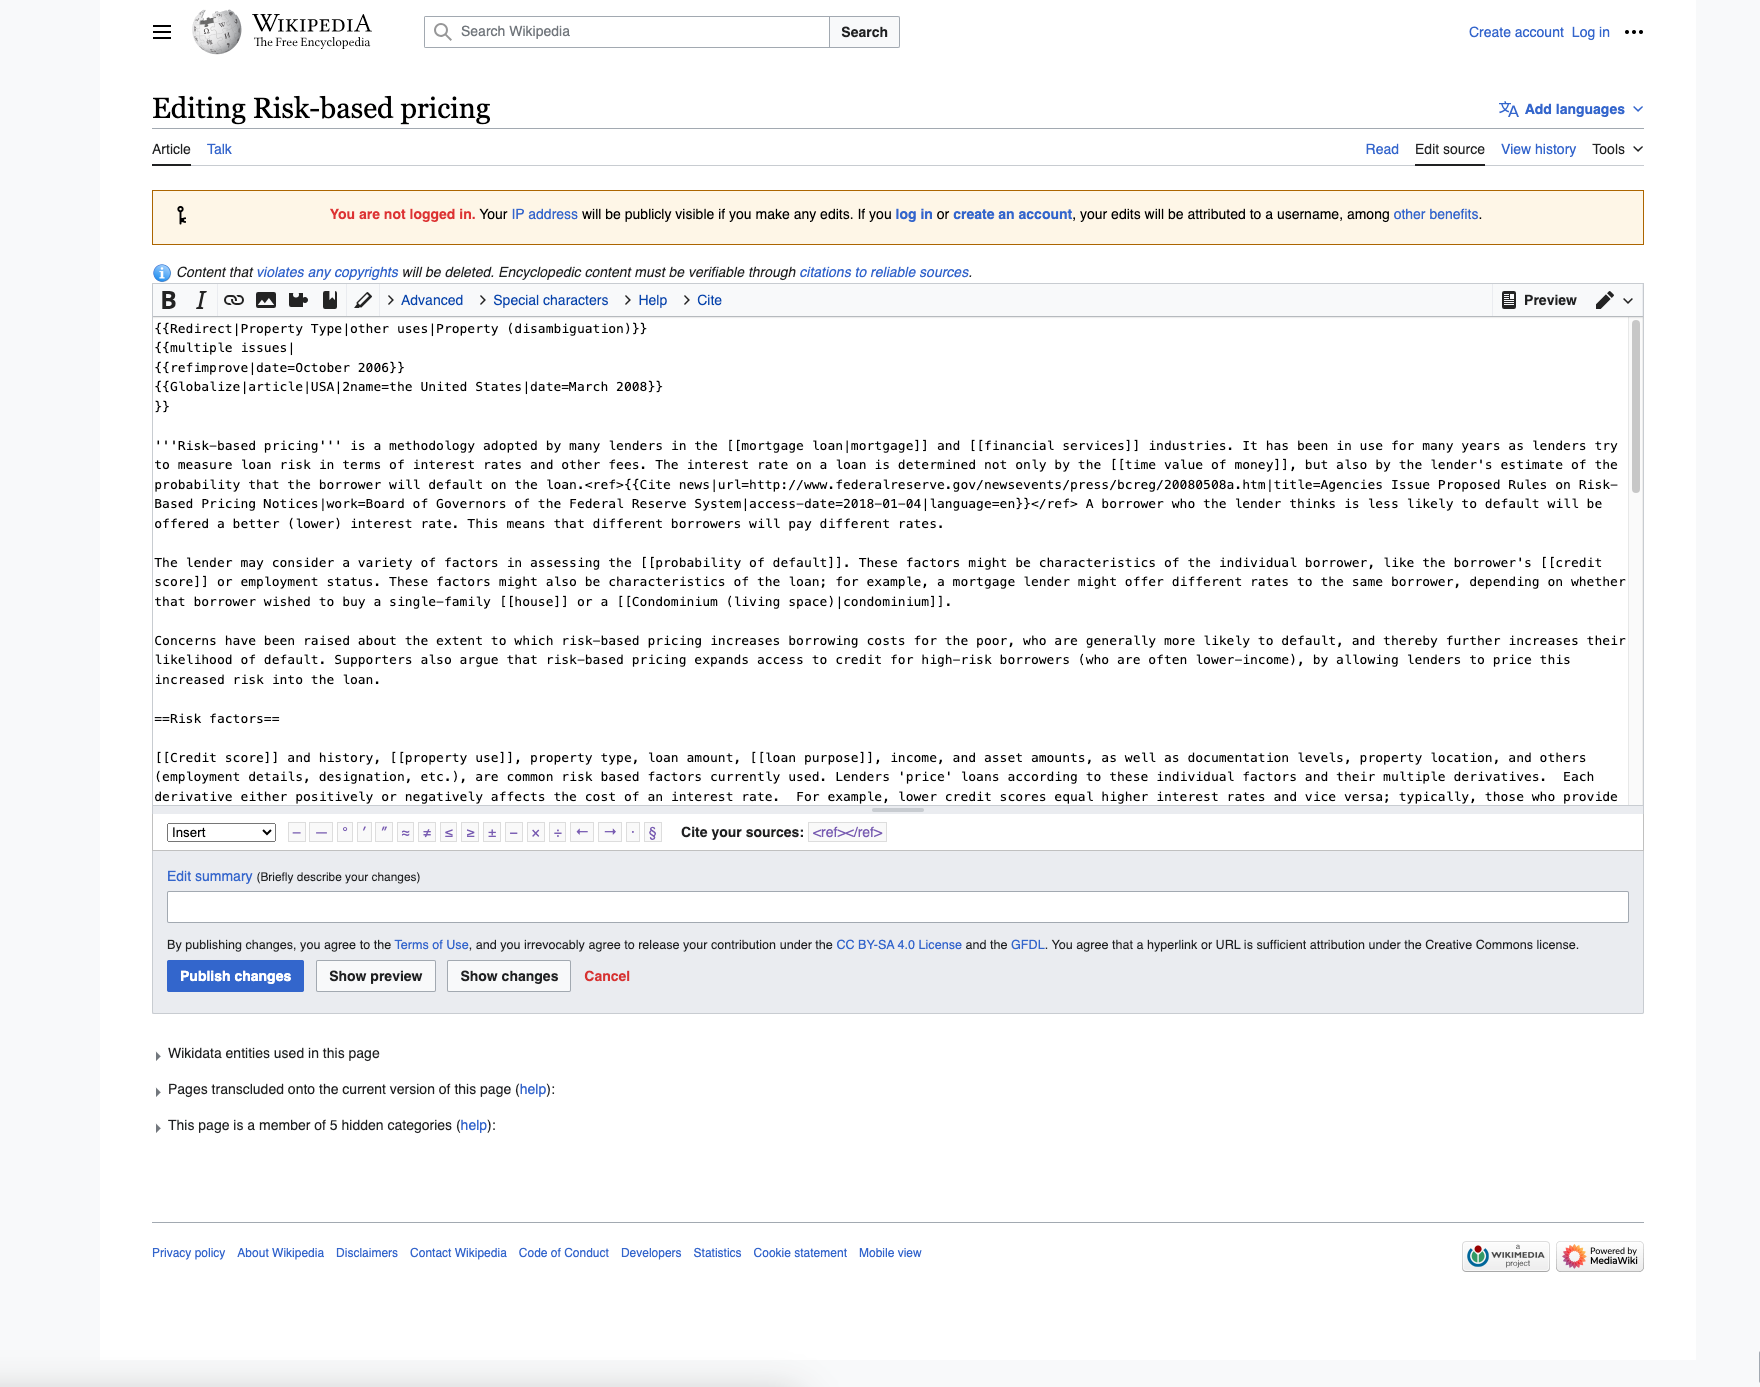
Als ich in Postman eine POST-Abfrage vorbereitet hatte, um Daten an Weaviate zu senden und zu indexieren, fiel mir eine deutliche Verzögerung beim Indexieren auf. Sie entsteht vor allem dadurch, dass Weaviate Sätze in Vektoren umwandelt, was viel Rechenleistung kostet. Wie bereits erwähnt, hat mein Kubernetes-Node keine GPU. Ich habe dasselbe Setup auch bei Hyperscalern wie GKE und AKS versucht, stiess dort aber zum aktuellen Zeitpunkt auf einen erheblichen Mangel an GPUs.
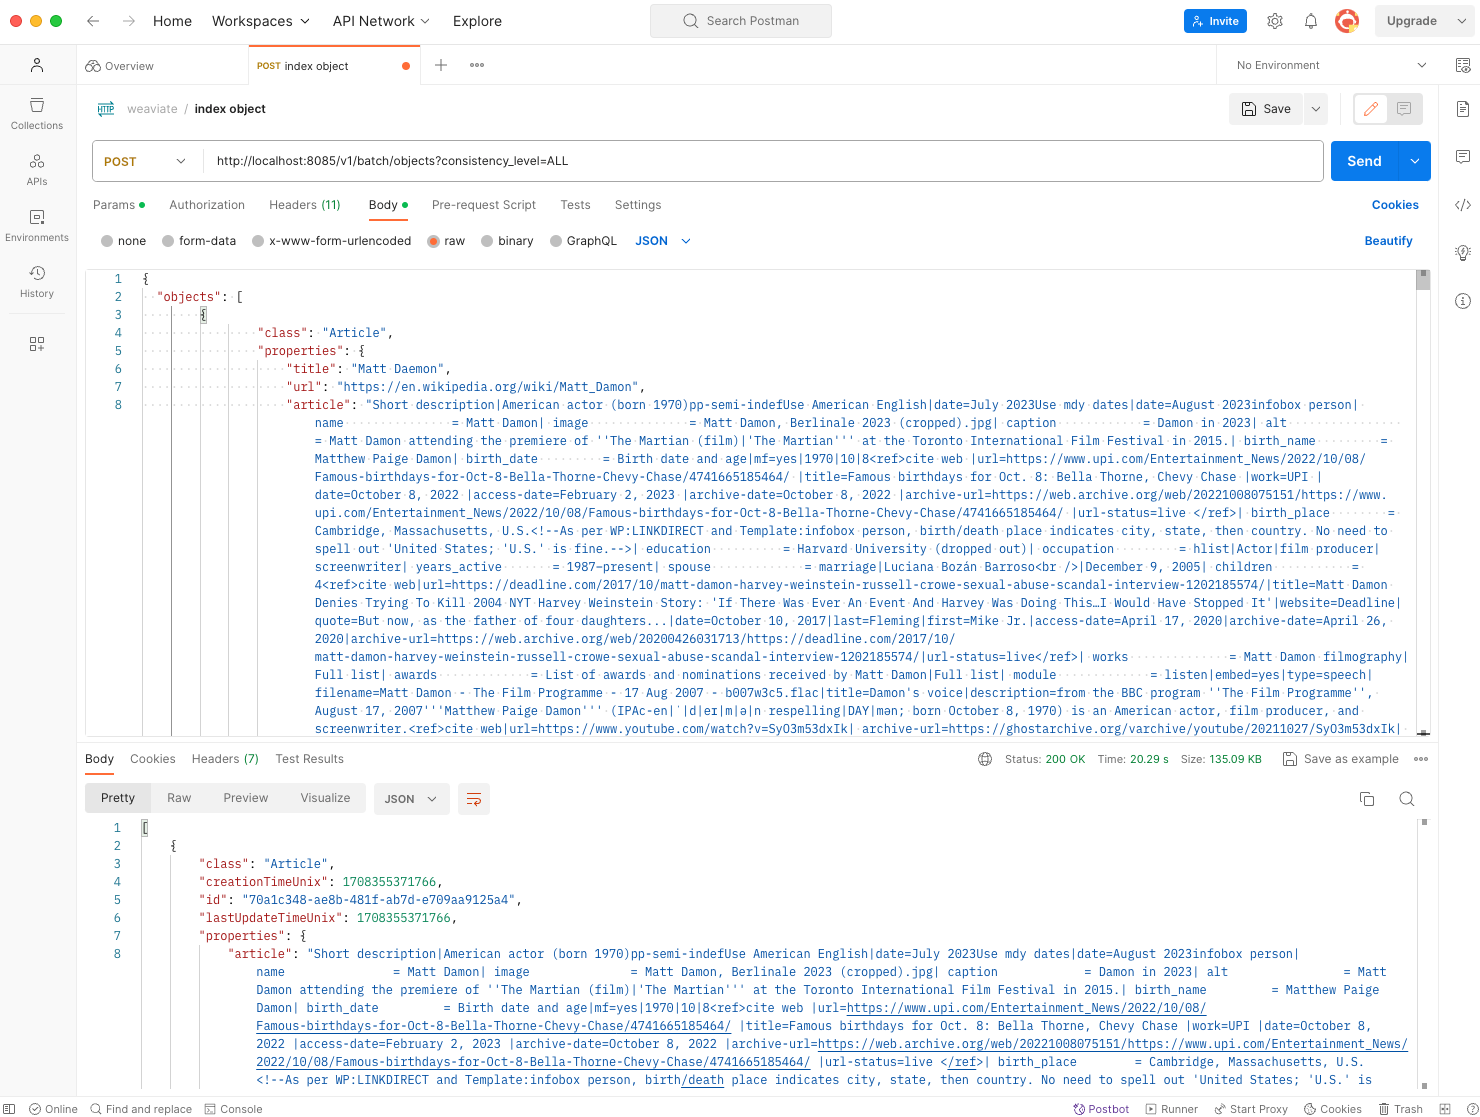
Über eine API, die alle indexierten Objekte zurückgibt, konnte ich prüfen, dass das Objekt indexiert war. Auf dieselbe Weise habe ich weitergemacht und rund 60 zufällige Wikipedia-Artikel indexiert.
# weaviate - query all indexed objects
curl http://localhost:8085/v1/objects?class=Article&&limit=100
Sehr gut, jetzt ist es Zeit für ein paar Abfragen!
Einfache Suche
An diesem Punkt habe ich ein paar einfache Suchabfragen ausprobiert, nur um zu sehen, ob Weaviate richtig funktioniert. Bei der Suche nach «matt» liefert es das indexierte Objekt mit einer Certainty (Sicherheit) von rund 70 % zurück.

Hier die GraphQL-Abfrage, die ich verwendet habe.
{
Get {
    Article(
        nearText: {
            concepts: ["who is matt"],
            certainty: 0.3
        },
        limit: 3
    ){
        title
        _additional {
            certainty
        }
    }
}
}
Weaviate – GraphQL-Abfrage für die einfache Suche
Erweiterte Suche: QnA Transformer
Jetzt versuchen wir, Antworten aus unseren indexierten Wikipedia-Artikeln herauszuziehen. Ich habe mir ein paar Fragen zu «Matt Damon» überlegt, dem Artikel, den wir vorhin indexiert haben. «What is the profession of matt daemon?» («Welchen Beruf hat Matt Damon?») ist eine gute Frage, weil der Artikel das Wort «profession» nicht einmal enthält.
Als QnA-Transformer-Modell hatte ich ursprünglich bert-large-uncased-whole-word-masking-finetuned-squad vorgesehen (ein Modell mit 335 Millionen Parametern). Beim Testen bekam ich aber Probleme mit Timeouts: Das Modell war auf meinem Kubernetes-Node ohne GPU schlicht zu langsam. Deshalb habe ich mich für ein anderes Modell entschieden: distilbert-base-uncased-distilled-squad, das «nur» 66,4 Millionen Parameter hat.

{
    Get {
        Article(
            ask: {
                question: "what is the profession of matt daemon?",
                properties: ["article"]
            },
            limit: 1
        ){
            title
            _additional {
                answer {
                    hasAnswer
                    property
                    result
                    startPosition
                    endPosition
                }
            }
        }
    }
}
Weaviate-GraphQL-Abfrage – Suche mit QnA
Das System hat herausgefunden, dass Matt Damon «actor, film producer and screenwriter» ist, also Schauspieler, Filmproduzent und Drehbuchautor.
Sehr gut – das scheint zu stimmen!
Fazit
Das sind die Ziele, die ich mir gesetzt hatte, als ich begann, Weaviate genauer anzuschauen. Ich denke, wir haben sie jetzt alle erreicht.
- KI on premise
Eine KI, die lokal on premise läuft. - Wissensdatenbank
Sie soll mit Textdaten arbeiten können (also mit einer Wissensdatenbank). - Frage, Antwort
Ich möchte eine Frage stellen können (deren Antwort in der Wissensdatenbank steht).
Das System soll den passenden Artikel finden und die Frage beantworten. - API-Integration
Das System soll eine API haben, damit es sich einfach mit meinen anderen Systemen verbinden lässt.
Ein UI-Frontend für Abfragen
Es könnte sich lohnen, ein eigenes UI bzw. Web-Frontend für die Interaktion mit Weaviate zu entwickeln. Das würde das Ausführen von Suchabfragen vereinfachen. Lassen Sie uns wissen, ob Sie ein Beitrag zu diesem Thema interessieren würde.
Bis zum nächsten Mal
Auch wenn ich inzwischen ein solides Verständnis von neuronalen Netzen, Natural Language Processing (NLP), Tokenisierung und Embedding-Modellen habe, finde ich es nach wie vor faszinierend, die Möglichkeiten und Anwendungsfälle von KI und Vektorsuchmaschinen zu sehen.
Ich hoffe, dieser Beitrag war auch für Sie interessant – bis zum nächsten Mal.
Links, Ressourcen