KI on premise – Teil 1: Theorie


Alle sensiblen Daten in eine KI-Wissensdatenbank einspeisen, die Ihre Fragen beantwortet? Kein Problem – solange sie im eigenen Haus läuft.
opensight.ch - roman hüsler
LLMs sind der letzte Schrei, ein grosser Schritt in der Digitalisierung und eine disruptive Technologie. Nicht ohne Grund fragen sich viele Unternehmen, wie sie diese Technologie im eigenen Betrieb nutzen können. Sensible Unternehmensdaten lassen sich meist nicht einfach zur Auswertung an eine Cloud-KI wie ChatGPT schicken. Deshalb fragen sich Unternehmen oft, wie sich KI-Lösungen intern und sicher einsetzen lassen.
KI lässt sich für die unterschiedlichsten Aufgaben einsetzen. In diesem Beitrag liegt der Fokus nicht auf LLMs – falls Sie sich für dieses Thema interessieren, lassen Sie es uns wissen. Stattdessen widmen wir uns einem verwandten Gebiet der KI: der Verarbeitung natürlicher Sprache (Natural Language Processing, NLP) und dem Aufbau einer «KI-gestützten Wissensdatenbank on premise». Dazu wird Ihre lokale Wissensdatenbank, etwa Confluence, angebunden, um ein KI-System für Fragen und Antworten zu entwickeln.
Heute schauen wir uns Weaviate an: eine KI-gestützte Vektorsuchmaschine, die mit vortrainierten Sprachmodellen arbeitet und sich intern bzw. on premise betreiben lässt.
opensight.ch - roman hüsler
Wie viele IT-Fachleute eigne auch ich mir gerade Wissen auf diesem Gebiet an. Ich nehme an, dass es vielen Leserinnen und Lesern dieses Blogs ähnlich geht und sie wohl genau deshalb auf diesen Beitrag gestossen sind. Sie müssen also kein KI-Spezialist sein, um diesem Beitrag folgen zu können.
Inhalt
Das grosse Ziel: KI on premise
Zuerst stecken wir den Rahmen für diese Blogserie ab. Das wollen wir erreichen:
- KI on premise
eine KI, die lokal on premise läuft - Wissensdatenbank
sie soll mit Textdaten arbeiten können (also mit einer Wissensdatenbank) - Frage, Antwort
ich möchte eine Frage stellen können (deren Antwort in der Wissensdatenbank steht). Das System soll den passenden Artikel finden und die Frage beantworten - API-Integration
es soll eine API haben, damit es sich einfach mit meinen anderen Systemen verbinden lässt
Was ist eine Vektorsuchmaschine?
«Weaviate ist eine quelloffene, Cloud-native Vektordatenbank, mit der Sie vektorisierte Daten speichern und abfragen können. Sie ist für hochdimensionale Daten ausgelegt und besonders nützlich für Anwendungen des maschinellen Lernens. Weaviate verfolgt einen schemabasierten Ansatz und unterstützt semantische Vektorisierung, wodurch sich komplexe Datenstrukturen effizient durchsuchen und abrufen lassen. Mit Weaviate interagieren Sie über die REST-API, die sich für die Integration mit verschiedenen Programmiersprachen eignet, darunter Python, JavaScript, C# und Go. Für den Einstieg können Sie die Dokumentation durchsehen und die Codebeispiele in Ihrer bevorzugten Programmiersprache verwenden.»
traditional search engine
-------------------------
indexed_sentences:
- "i have seen a giraffe in the zoo"
- "in the wildlife park, i've seen an elephant yesterday"

vector search engine
-------------------------
indexes_sentences:
- [0.34837, 0.84732, ...]
- [0.39872, ...]
In einer klassischen Suchmaschine werden Inhalte indexiert und gespeichert, damit man sie schnell durchsuchen kann. Indexieren Sie zum Beispiel den Satz «I have seen a giraffe in the zoo» («Ich habe im Zoo eine Giraffe gesehen»), finden Sie diesen Eintrag ganz einfach, wenn Sie nach «zoo» suchen. Den Satz mit dem Wort «elephant» (oben) finden Sie dagegen nicht, weil er das Wort «zoo» nicht enthält.
Vektorsuchmaschinen hingegen lernen, welche Wörter miteinander zusammenhängen und im jeweiligen Kontext relevant sind. Ihr Index arbeitet mit vektorisiertem Text, also mit Text, der als Zahlenwerte dargestellt ist. KI-Modelle so zu trainieren, dass sie Text in Zahlen umwandeln, erfordert erhebliche Rechenleistung und eine grosse Menge an Beispieltext. Deshalb können wir mit unserer Vektorsuchmaschine (Weaviate) vortrainierte Modelle verwenden.
Angenommen, Sie suchen nach «Which animals could I meet in the zoo?» («Welchen Tieren könnte ich im Zoo begegnen?»). Die Magie einer Vektorsuchmaschine liegt darin, dass sie unter Umständen beide indexierten Einträge (oben) findet, weil sie mit einer grossen Bandbreite an Textbeispielen trainiert wurde. Sie versteht, dass die Wörter «zoo», «animal», «elephant» und «giraffe» inhaltlich eng zusammenhängen. Schauen wir uns die Verarbeitung natürlicher Sprache mit neuronalen Netzen genauer an und sehen wir, wie das möglich ist.
Hintergrund: NLP mit neuronalen Netzen
Wie neuronale Netze mit Natural Language Processing (NLP) Text und Sprache «verstehen» – in aller Kürze.
Schritt 1 – Text in Zahlen umwandeln
Text muss in Zahlen umgewandelt werden, damit neuronale Netze ihn verarbeiten können. Im Kern ist das einfach: Man füttert viel Text hinein und weist jedem Wort eine Zahl zu. Das Ergebnis ist ein Wörterbuch fester Grösse mit den häufigsten Wörtern. Wer mit textbasierten Daten und KI arbeiten will, muss den Text zwingend in Zahlen umwandeln.
Simple Example Dictionary with just 4 words

"the dog ate the wiener"
[0, 1, 2, 0, 3]

0: the
1: dog
2: ate
3: wiener
Schritt 2 – Embeddings erzeugen
Das neuronale Netz muss Word Embeddings lernen, also welche Wörter miteinander zusammenhängen. Das geschieht durch Training mit vielen Textbeispielen und dem zuvor erstellten Wörterbuch (Schritt 1).
text sample sentence:
"the dog ate the ___" (correct answer: "wiener")

possible answer:
"pancakes"

wrong answer:
"window"
Beim Training baut das neuronale Netz einen hochdimensionalen Vektorraum für die Embeddings auf, um die Beziehungen zwischen Wörtern zu lernen. Dazu nimmt es ein Textbeispiel, entfernt ein zufälliges Wort und versucht dann, das fehlende Wort aus dem Kontext vorherzusagen. Indem das Netz sehr viele Textbeispiele sieht, lernt es diese Beziehungen.
Es begegnet zum Beispiel Sätzen wie «a dog ate a wiener» («ein Hund frass ein Würstchen»), aber nicht Sätzen wie «a dog ate a window» («ein Hund frass ein Fenster»). Auch wenn «window» und «wiener» im Wörterbuch nahe beieinander stehen mögen, haben sie inhaltlich nichts miteinander zu tun.
Dieses Training braucht sehr viele Textbeispiele und Rechenleistung. Deshalb können wir mit Weaviate vortrainierte Sentence und QnA Transformers verwenden.
opensight.ch - roman hüsler
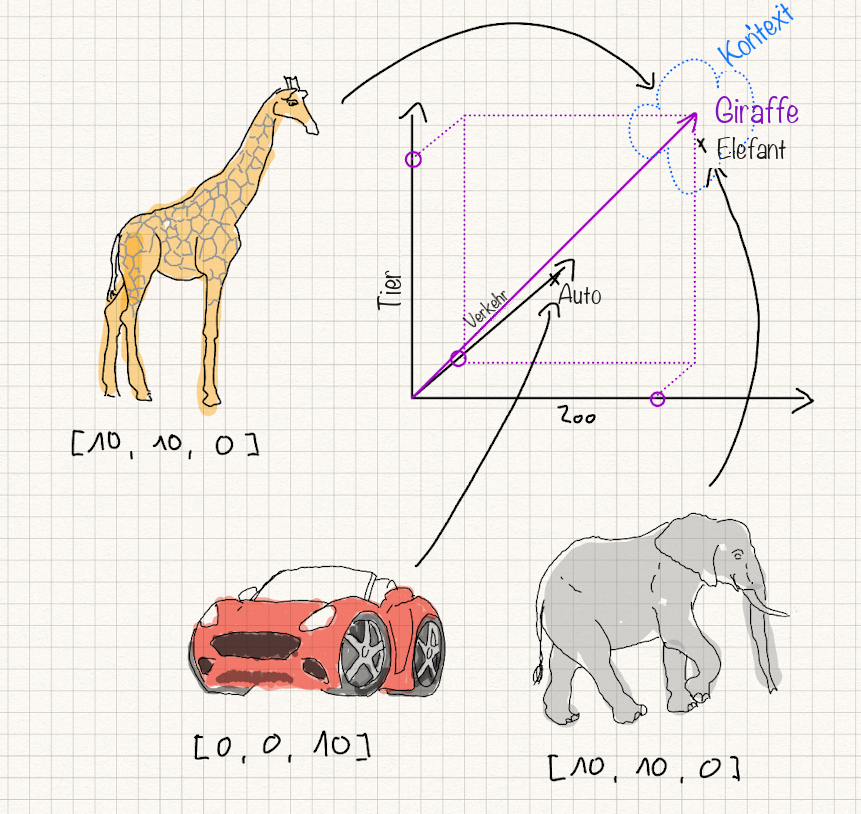
Noch ein Beispiel dafür, wie ich mir Vektor-Embeddings persönlich vorstelle. Nehmen wir drei Wörter: «Elefant», «Giraffe», «Auto». Und eine NLP-Embedding-Schicht mit nur drei Dimensionen, die Folgendes darstellen:
Dimension 1 Zoo: «Wie viel hat etwas mit ‹Zoo› zu tun?»
Dimension 2 Tier: «Wie viel hat etwas mit ‹Tier› zu tun?»
Dimension 3 Verkehr: «Wie viel hat etwas mit ‹Verkehr› zu tun?»
«Giraffe» und «Elefant» erreichen dann hohe Werte in Dimension 1 und 2 und einen tiefen Wert in Dimension 3. Auf zwei Dimensionen teilen sie also einen ähnlichen Kontext. Das Wort «Auto» erreicht einen hohen Wert in Dimension 3 und liegt deshalb nicht «in der Nähe» der beiden anderen Wörter.
Das ist nur ein Beispiel. In einem echten Modell kann es Tausende von Dimensionen geben, und man weiss nicht, welchen Faktor sie jeweils darstellen. Die Dimensionen lernt ein neuronales Netz automatisch, indem es sehr viele Textbeispiele betrachtet und seine Gewichte anpasst. Wenn Sie tiefer einsteigen und verstehen möchten, wie das funktioniert, kann ich Ihnen folgenden Kurs empfehlen:
Tensorflow - Zero to Mastery
Weaviate Sentence Transformers
Weaviate ist eine Vektorsuchmaschine – sie speichert bzw. indexiert unsere Inhalte als Zahlen. Dafür verwenden wir einen vortrainierten Sentence Transformer von Hugging Face / SeMI Technologies. Hier eine Liste möglicher Transformer, die Sie verwenden können:
Link – Weaviate text2vec-transformers
Es ist auch möglich, Cloud-basierte Transformer (etwa von OpenAI) per API-Schlüssel einzubinden oder sogar einen eigenen Sentence Transformer zu trainieren und einzusetzen.
Der Sentence Transformer, den wir verwenden, wurde mit 215 Millionen Frage-Antwort-Paaren aus unterschiedlichsten (mehrsprachigen) Quellen trainiert und arbeitet mit einem dichten Vektorraum von 384 Dimensionen. Beim Indexieren wird also jeder Satz in einen 384-dimensionalen Vektor umgewandelt. Er wurde für die semantische Suche entwickelt und eignet sich damit ideal für unseren Zweck: zu einer Suchanfrage den passenden Artikel in der Wissensdatenbank zu finden.
Das Vectorizer-Modell auf Hugging Face:
semitechnologies/transformers-inference:sentence-transformers-multi-qa-MiniLM-L6-cos-v1
Im nächsten Teil dieser Blogserie binden wir diesen Transformer in Weaviate ein.
Weaviate QnA Transformers
Ausserdem probieren wir einen QnA Transformer aus. Dieser KI-Transformer ist dafür zuständig, aus dem Artikel der Wissensdatenbank die richtige Antwort auf unsere Suchanfrage herauszuziehen.
Hier die Seite von Weaviate zu Question-and-Answer-Transformern:
Weaviate – QnA Transformers
Als QnA Transformer verwenden wir:
semitechnologies/qna-transformers:bert-large-uncased-whole-word-masking-finetuned-squad
Fazit
Damit ist der Theorieteil abgeschlossen. Im nächsten Teil setzen wir alles in die Praxis um. Abonnieren Sie unseren Blog, damit Sie beim nächsten Teil dieser Blogserie dabei sind:
KI on premise – Teil 2: Praxis