Kafka in Produktion: von null zum Profi (Teil 5)


Kafka in Produktion – wir bauen einen skalierbaren, sicheren und Enterprise-tauglichen Message Bus auf der Google Cloud Platform. Jetzt geht es in die Cloud, genauer zum Hyperscaler Google Cloud und auf die Google Kubernetes Engine.
opensight.ch - roman hüsler
Inhaltsverzeichnis
- Teil 1 – Kafka-Einzelinstanz mit Docker
- Teil 2 – Kafka-Einzelinstanz mit Authentifizierung (SASL)
- Teil 3 – Kafka-Cluster mit TLS-Verschlüsselung, Authentifizierung und ACLs
- Teil 4 – Enterprise-Authentifizierung und Zugriffskontrolle (OAuth 2.0)
- Teil 5 – Produktiver Kafka-Cluster auf Google Cloud mit Strimzi
- Teil 6 – Observability und Data Governance mit Strimzi (folgt)
TL;DR
Ich empfehle zwar, die Blogposts zu lesen, aber ich weiss, dass manche direkt zur «Single Source of Truth» springen: zum Code. Das ist ungefähr so, wie an einem Freitag ungetestet zu deployen.
Bitte sehr:
Einführung
Apache Kafka ist eine leistungsfähige Event-Streaming-Plattform, doch der Betrieb in Produktion ist eine ganz andere Herausforderung. Wir beginnen mit den Grundlagen, aber das hier ist kein Spielplatz: Schritt für Schritt bauen wir einen Message Bus in Enterprise-Qualität, der Hochverfügbarkeit, Sicherheit und Skalierbarkeit für echte Workloads bietet.
Ich bin selbst kein Kafka-Spezialist, ich lerne unterwegs. Da wir inzwischen bei Teil 5 angekommen sind, muss ich allerdings sagen: Über den Betrieb von Kafka in Produktion in einer Enterprise-Umgebung habe ich in der Zwischenzeit eine Menge gelernt. Wie so oft bei den opensight-Blogs können Sie mich auf meinem Weg von null zum Profi begleiten.
In dieser Blogserie gehen wir mit Kafka über die Grundlagen hinaus. Wir entwerfen ein produktionsreifes Kafka-Cluster-Deployment, das folgende Eigenschaften hat:
- Skalierbar – bewältigt wachsende Last ohne Performance-Engpässe.
- Sicher – setzt Authentifizierung (Plain, SCRAM, OAUTH), Autorisierung (ACL, OAUTH) und Verschlüsselung (TLS) durch.
- Sauber strukturiert – inklusive Schema Registry für eine ordentliche Data Governance.
- Enterprise-tauglich – mit den Funktionen, die eine ereignisgesteuerte Architektur in einer grossen Umgebung braucht.
In diesem fünften Teil unserer Kafka-Blogserie deployen wir einen produktionsreifen Apache-Kafka-Cluster auf Google Kubernetes Engine (GKE) und nutzen alle Funktionen, die es für Zuverlässigkeit, Skalierbarkeit und Sicherheit braucht.
Dafür verwende ich Strimzi, einen Open-Source-Kubernetes-Operator, der den Betrieb von Apache-Kafka-Clustern auf Kubernetes (und OpenShift) auf wirklich Cloud-native Weise vereinfacht. Strimzi folgt dem Operator-Pattern und automatisiert Deployment, Verwaltung, Skalierung, Upgrades und Konfiguration der Kafka-Komponenten.
Statt komplexe Elemente wie Broker, Metadaten-Quorum (bei neueren Kafka-Versionen über KRaft), Topics und Benutzer von Hand zu konfigurieren, deklarieren Sie alles über Kubernetes Custom Resources (CRs). Dazu gehört die zentrale Ressource Kafka, kombiniert mit KafkaNodePool für eine flexible Zuweisung der Node-Rollen im KRaft-Modus.
Strimzi Kafka ist weit verbreitet, wenn Kafka produktionsreif auf Kubernetes laufen soll.
opensight.ch - roman huesler
Inhalt dieses Teils
Es gibt einiges zu tun:
-
Überblick über die Kafka-Architektur in der Cloud
Überblick darüber, was wir bauen -
Setup des Google-Kubernetes-Clusters
Aufbau des Basis-Clusters auf Google Kubernetes Engine -
- Strimzi Kubernetes Operator
Einrichtung des Strimzi-Operators, der die ganze Magie übernimmt - Kafka-Cluster-Ressourcen
Deployment des eigentlichen Kafka-Clusters mit den Strimzi-CRDs - Ein eigener Load Balancer pro Broker
Warum wir pro Broker einen eigenen Load Balancer verwenden
- Strimzi Kubernetes Operator
-
Konfiguration des Keycloak OAuth Authorizers
Wie die Kafka-Autorisierung über einen Keycloak-Server läuft -
Test-Applikation verbinden
Die Test-Applikation mit dem Kafka-Cluster verbinden und die Replikation prüfen -
Cluster-Skalierung mit Strimzi Cruise Control
Den Cluster hoch- und herunterskalieren -
Fazit
Erkenntnisse, Rückblick und Ausblick
Überblick über die Kafka-Architektur in der Cloud
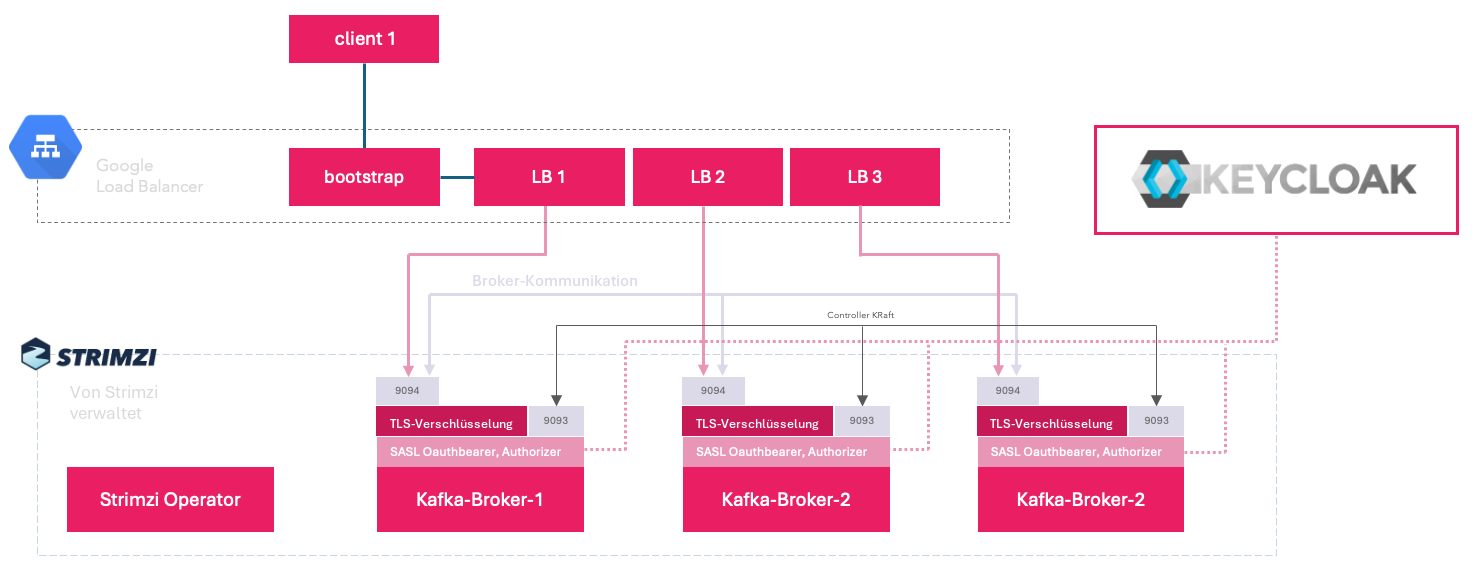
In diesem Setup verwenden und testen wir endlich alles, was ein produktionsreifes Deployment braucht:
- Google Cloud Kubernetes Engine
- Strimzi Kafka Operator 0.48
- Kafka im KRaft-Modus
- Verschlüsselte Kommunikation (TLS) mit den Clients
- OAuth-Authentifizierung, Strimzi Keycloak Authorizer
- Topic-Replikationsfaktor 3
- Skalierbarkeit des Kafka-Clusters über Strimzi Cruise Control
- Ein LoadBalancer-Service für den Bootstrap (für den ersten Verbindungsaufbau der Clients und das Abrufen der Metadaten) und ein separater LoadBalancer-Service pro Broker (warum? Lesen Sie weiter …)
Setup des Google-Kubernetes-Clusters
Der Aufbau eines Google-Kubernetes-Engine-Clusters (GKE) steht in diesem Artikel nicht im Mittelpunkt. Eine ausführliche Anleitung, wie Sie mit Terraform einen produktionsreifen GKE-Cluster provisionieren, finden Sie in unserem separaten Blogpost:
 Roman Hüsler
Für diesen Blogpost und die Demo im Labor habe ich mit Terraform einen GKE-Cluster mit einem eigenen Node-Pool aus nur einem Node provisioniert. Das hält die Kosten für Experimente und Tests tief.
In einer echten Produktionsumgebung sollten Sie jedoch selbstverständlich einen eigenen Node-Pool mit mindestens drei Nodes verwenden (idealerweise verteilt auf mehrere Availability Zones, also ein regionaler GKE-Cluster). Konfigurieren Sie ausserdem Pod-Anti-Affinity-Regeln (und optional Topology Spread Constraints) für die Kafka-Pods, um Hochverfügbarkeit sicherzustellen: So landen nicht mehrere Broker-Replicas auf demselben Node, und das Risiko gleichzeitiger Ausfälle sinkt.
Strimzi macht das einfach: Sie können diese Regeln direkt im Abschnitt template.pod.affinity Ihrer Kafka- oder KafkaNodePool-Ressourcen (bei KRaft-Deployments) definieren.
Strimzi-Kafka-Setup
Nun zum Setup des Strimzi-Kafka-Clusters auf Kubernetes. Werfen Sie kurz einen Blick auf die Website https://strimzi.io/. Mit Strimzi betreiben Sie Kafka auf Ihrem Kubernetes in verschiedenen Deployment-Konfigurationen, und es ist in produktiven Setups weit verbreitet.
Strimzi Kubernetes Operator
Als Basis deployen wir als Nächstes den Strimzi Cluster Operator. Er übernimmt die ganze Schwerarbeit: Er automatisiert Deployment, Skalierung (nach oben und unten), Upgrades, Monitoring und Wartung der Kafka-Komponenten.
Für dieses Labor-Setup habe ich ihn unverändert über das offizielle Helm-Chart mit den Standardwerten installiert; für einen schnellen Start braucht es keine eigenen Overrides. Hier der Befehl, den ich verwendet habe (mit der damals aktuellen stabilen Version, etwa 0.48.x):
 strimzi
Kafka-Cluster-Ressourcen
Für die Demonstrationen in diesem Blogpost habe ich den Kafka-Cluster (und zugehörige Ressourcen wie Topics und Benutzer) mit einem eigenen Helm-Chart deployt, das die nötigen Strimzi Custom Resources (CRs) bündelt.
Hier das YAML meines Kafka-Clusters, ein Teil des Helm-Charts:
apiVersion: kafka.strimzi.io/v1beta2
kind: Kafka
metadata:
  name: kafka-cluster
  namespace: kafka
  labels:
    app: {{ include "opensight-strimzi-deployment.fullname" . }}
    chart: {{ include "opensight-strimzi-deployment.chart" . }}
    release: {{ .Release.Name }}
    heritage: {{ .Release.Service }}
spec:
  kafka:
    version: "4.1.0"
    # OAuth-based authorization using KeycloakAuthorizer for KRaft mode
    authorization:
      type: keycloak
      authorizerClass: "io.strimzi.kafka.oauth.server.authorizer.KeycloakAuthorizer"
      tokenEndpointUri: "https://auth.opensight.ch/auth/realms/master/protocol/openid-connect/token"
      clientId: "kafka-broker"
      delegateToKafkaAcls: false

    listeners:
      - name: controller
        port: 9093
        type: "internal"
        tls: false

      - name: plain
        port: 9092
        type: "internal"
        tls: false

      - name: external
        port: 9094
        type: "loadbalancer"
        tls: true
        authentication:
          type: oauth
          clientId: "kafka-broker"
          clientSecret:
            secretName: "kafka-oauth-client-secret"
            key: "client-secret"
          tokenEndpointUri: "https://auth.opensight.ch/auth/realms/master/protocol/openid-connect/token"
          validIssuerUri: "https://auth.opensight.ch/auth/realms/master"
          jwksEndpointUri: "https://auth.opensight.ch/auth/realms/master/protocol/openid-connect/certs"
          userNameClaim: "preferred_username"
        configuration:
          # Bootstrap LoadBalancer service (for initial client connection and metadata discovery)
          # Per-broker LoadBalancer services (one per broker for direct connections)
          brokers:
            - broker: 0
            - broker: 1
            - broker: 2

    # Kafka configuration
    config:
      offsets.topic.replication.factor: 3
      transaction.state.log.replication.factor: 3
      transaction.state.log.min.isr: 2
      default.replication.factor: 3
      min.insync.replicas: 2
      inter.broker.protocol.version: "3.6"
      log.message.format.version: "3.6"
      # KeycloakAuthorizer configuration properties
      strimzi.authorization.token.endpoint.uri: "https://auth.opensight.ch/auth/realms/master/protocol/openid-connect/token"
      strimzi.authorization.client.id: "kafka-broker"
      strimzi.authorization.allow.everyone.if.no.acl.found: "false"

  entityOperator:
    topicOperator: {}
    userOperator: {}

  cruiseControl:
    config:
      anomaly.detection.interval.ms: "300000"
      max.num.cluster.movements: "1250"
      metrics.window.ms: "300000"
      num.concurrent.partition.movements.per.broker: "5"
      num.metrics.windows: "20"
      num.proposal.precompute.threads: "1"
      sample.loading.check.interval.ms: "5000"
      self.healing.broker.failure.enabled: "true"
      self.healing.disk.failure.enabled: "true"
      self.healing.enabled: "true"
      self.healing.goal.violation.enabled: "true"
      topic.config.provider.class: "com.linkedin.kafka.cruisecontrol.config.BrokerSetAwareTopicConfigProvider"
    resources:
      limits:
        cpu: 500m
        memory: 1Gi
      requests:
        cpu: 200m
        memory: 512Mi
Nachdem die Ressourcendefinitionen angewendet waren, habe ich dem Strimzi-Operator etwas Zeit gegeben, um den Cluster, die Load Balancer auf Google Cloud, die Zertifikate, die Benutzer und das test-topic einzurichten.
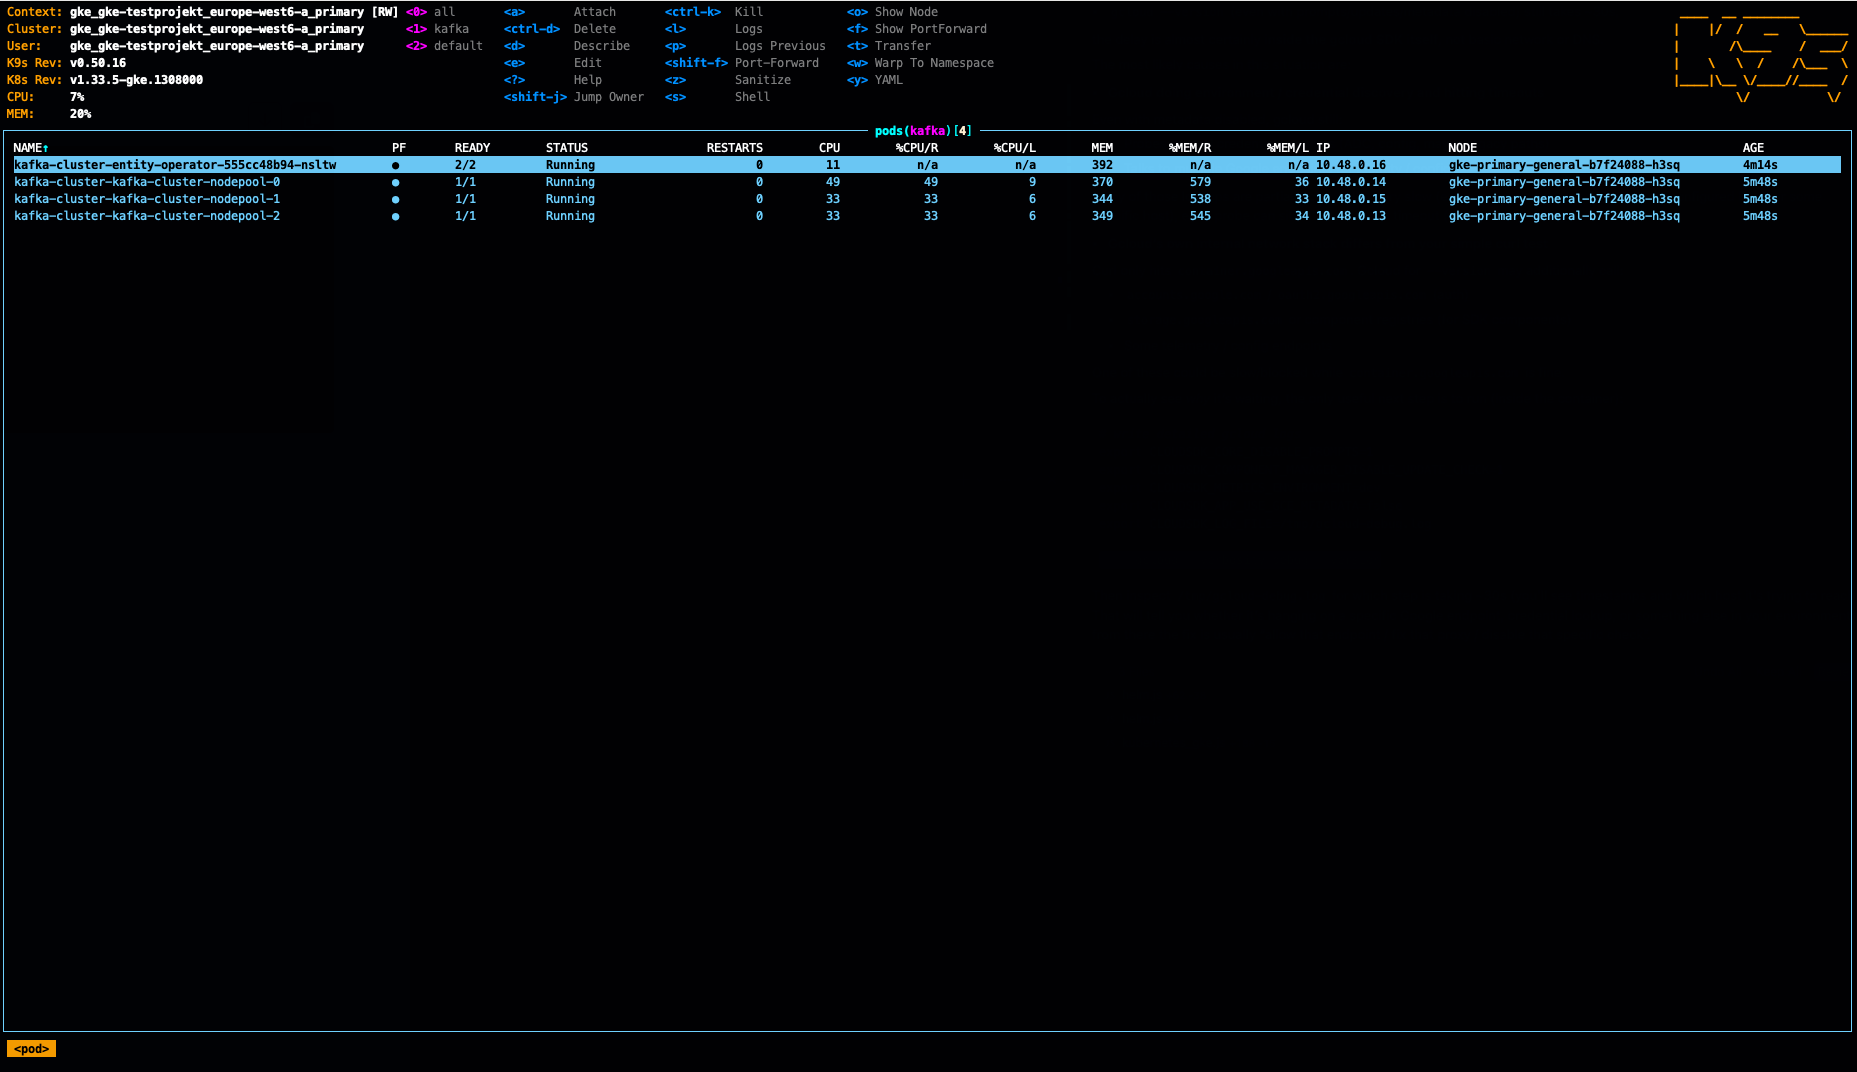
Ja, alle Pods laufen auf demselben einzelnen Node. Wie erwähnt diente das nur dazu, im Demo-Labor Kosten zu sparen. Mir ist ausserdem aufgefallen, dass standardmässig keine Pod-Anti-Affinity-Regeln definiert sind; darum müsste man sich also selbst kümmern.
Ein eigener Load Balancer pro Broker
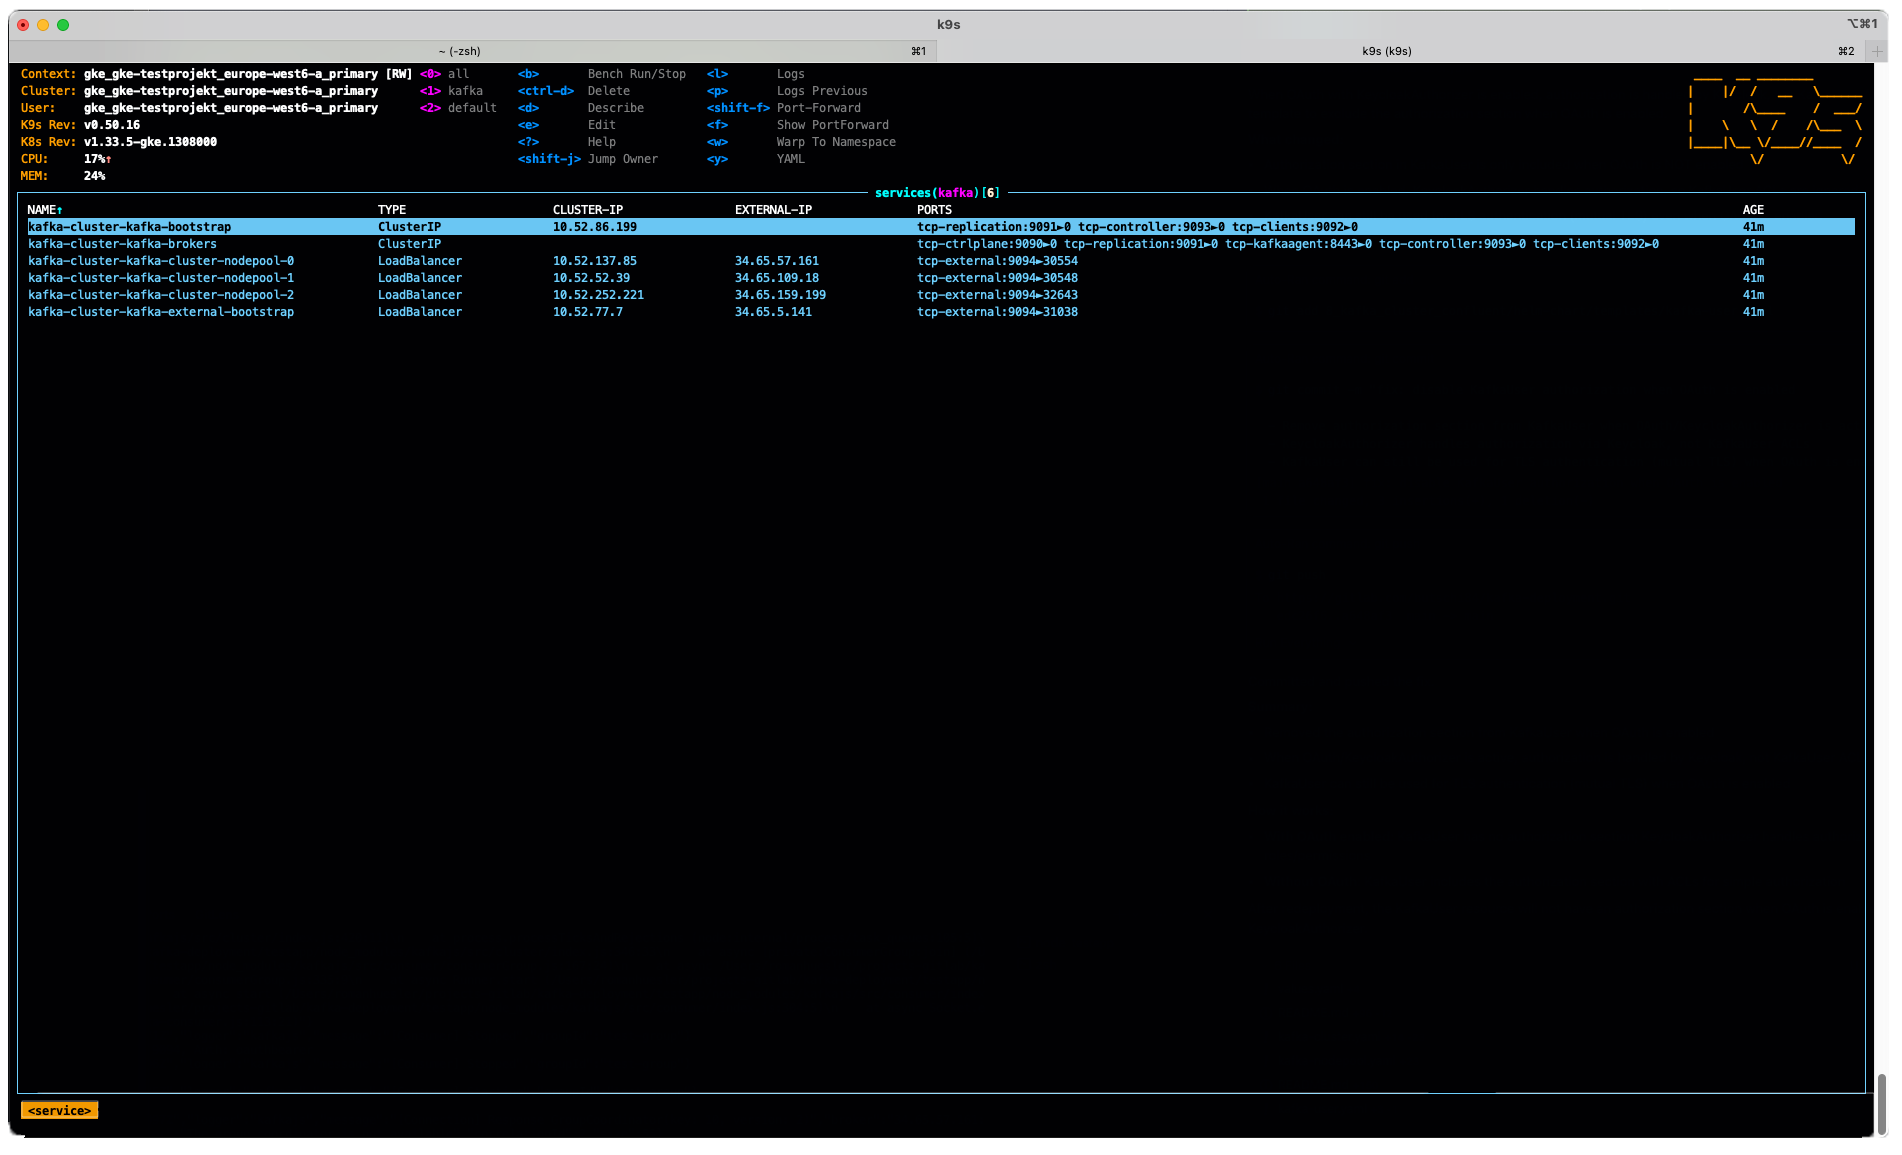
Ich habe mich gefragt, warum man pro Broker einen Load Balancer verwenden sollte, obwohl er den Verkehr nur an einen einzigen Broker-Pod weiterleitet, denn das hat Kostenfolgen. Mehr zum Thema finden Sie im Strimzi-Blog. Kurz gesagt: Wir nutzen den Load Balancer des Hyperscalers, weil der Verkehr damit direkt zum richtigen Node gelangt, ohne Umwege über andere Nodes:
When Kubernetes creates the load balancer, they usually target it to all nodes of your Kubernetes cluster and not only to the nodes where your application is actually running. That means that although the TCP connections will always end on the same node in the same broker, they might be routed through the other nodes of your cluster. When the connection is sent by the load balancer to the node which does not host the Kafka broker, the
kube-proxycomponent of Kubernetes will forward it to the right node where the broker runs.
Konfiguration des Keycloak OAuth Authorizers
Lesen Sie Teil 4 dieser Blogserie, um mehr über die Keycloak-Integration zu erfahren. Jeder Client, der sich mit Kafka verbindet, holt sich zuerst ein Autorisierungstoken von unserem Keycloak-Server.
In Keycloak habe ich einen Client eingerichtet, mit dem die Broker ein Token abrufen und untereinander kommunizieren können.
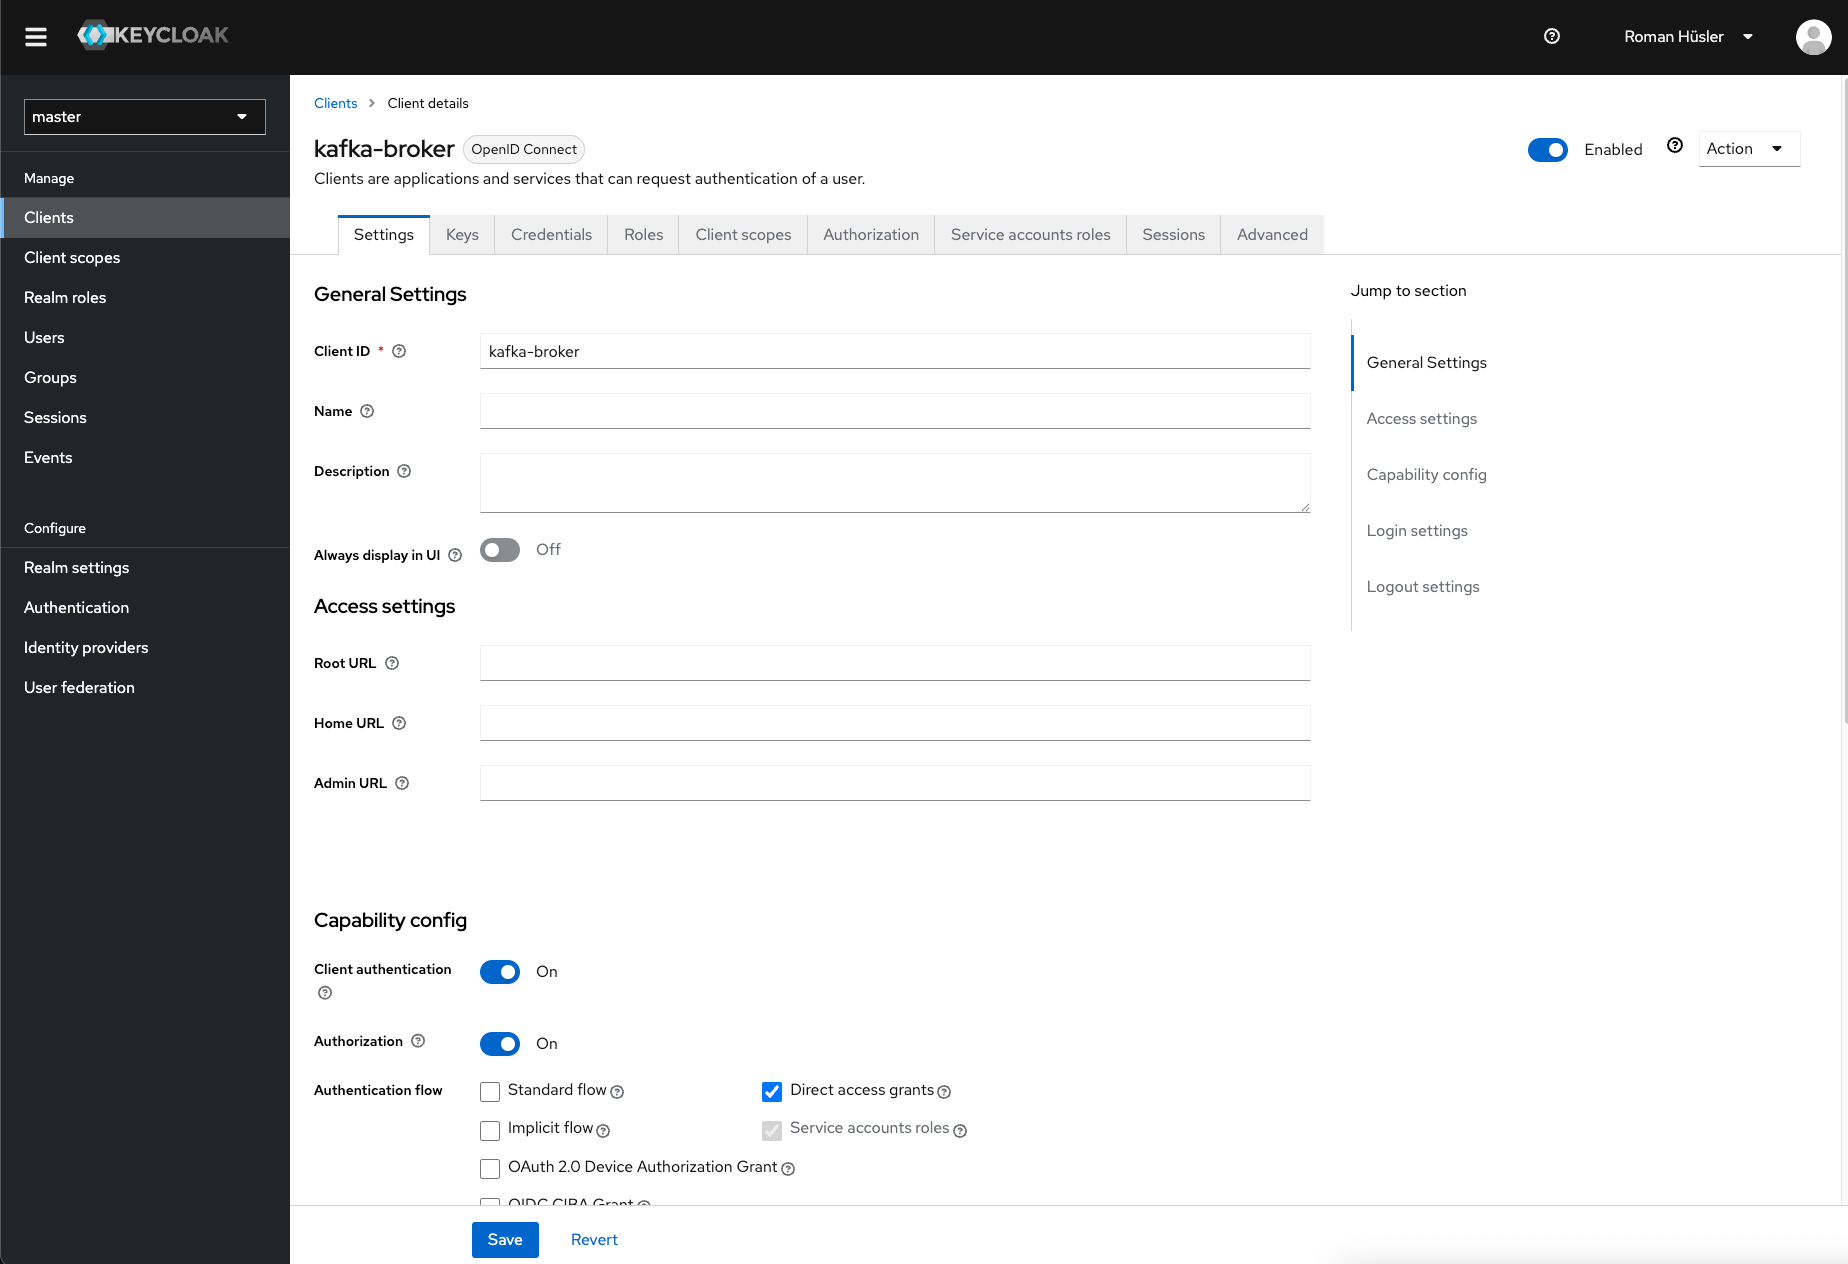
Das Secret des Keycloak-Clients kafka-broker (unter «Credentials») habe ich in ein Kubernetes-Secret gelegt.
kubectl create secret generic kafka-oauth-client-secret \
  --from-literal=client-secret='YOUR_CLIENT_SECRET' \
  -n kafka
Es wird hier verwendet: https://github.com/butschi84/kafka-enterprise-deployment/blob/main/5_cluster_google_kubernetes_engine/helm-chart/templates/kafka-cluster.yaml#L41
Test-Applikation verbinden
Einen Kafka-Benutzer habe ich mit Strimzi hier deployt. Strimzi hat mit seiner CA ein Zertifikat erzeugt, mit dem sich der Benutzer verbindet. Exportieren wir die Zertifikate und den privaten Schlüssel und verbinden dann die Test-Applikation. Die Test-Applikation finden Sie hier.
# get kafka cluster ca-certificate
kubectl get secret -n kafka kafka-user -o jsonpath='{.data.ca\.crt}' | base64 -d > ca.crt

# get kafka-user certificate
kubectl get secret -n kafka kafka-user -o jsonpath='{.data.user\.crt}' | base64 -d > user.crt

# get kafka-user private key
kubectl get secret -n kafka kafka-user -o jsonpath='{.data.user\.key}' | base64 -d > user.key
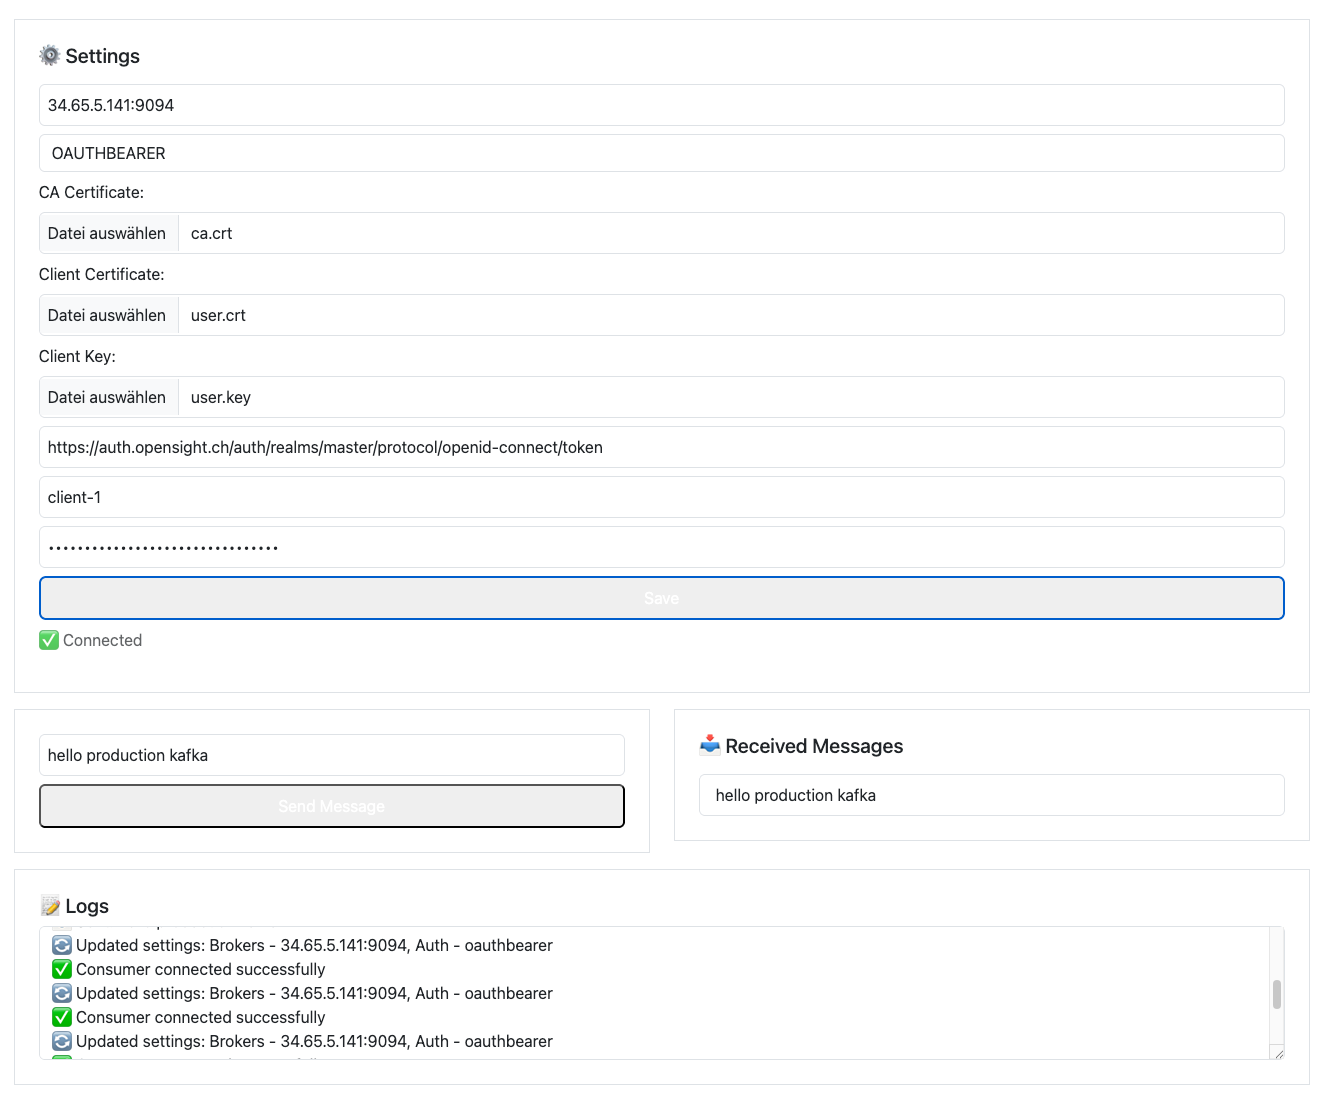
Der Cluster funktioniert einwandfrei. Ich kann Nachrichten produzieren und empfangen.
Cluster-Skalierung mit Strimzi Cruise Control
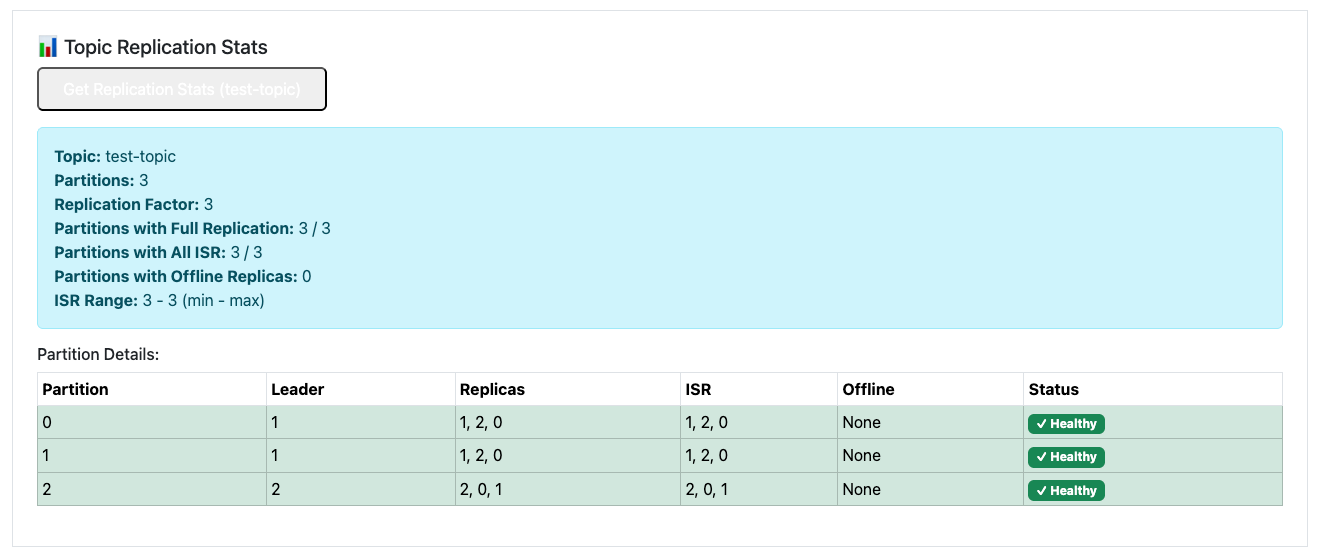
Zuerst versuche ich, den Cluster von 3 auf 5 Broker hochzuskalieren. Die Test-Applikation in unserem Git-Repository hat ein kleines Update erhalten und kann jetzt Replikationsstatistiken der Kafka-Topics anzeigen. Wie erwartet sind die 3 Partitionen im Moment auf 3 Broker verteilt.
Simulieren wir ein realistisches Szenario: Der Verkehr auf unserem Kafka-Cluster hat deutlich zugenommen, und das bisherige Setup mit 3 Brokern reicht nicht mehr aus. Horizontale Skalierung ist eine der Stärken von Kafka, und Strimzi macht sie ausgesprochen einfach.
Um von 3 Brokern auf 5 zu skalieren, passen wir einfach das Feld spec.replicas in der KafkaNodePool-Ressource der Broker an (ausgehend von einem gängigen Produktions-Setup mit getrennten Controller- und Broker-Pools im KRaft-Modus).
# scale nodepool to 5 replicas
kubectl patch kafkanodepool kafka-cluster-nodepool -n kafka --type='json' -p='[{"op": "replace", "path": "/spec/replicas", "value": 5}]'

# add listeners for new brokers to route traffic to
kubectl patch kafka kafka-cluster -n kafka --type='json' -p='[{"op": "replace", "path": "/spec/kafka/listeners/2/configuration/brokers", "value": [{"broker": 0}, {"broker": 1}, {"broker": 2}, {"broker": 3}, {"broker": 4}]}]'

# we need now 5 partitions
kubectl patch kafkatopic test-topic -n kafka --type='json' -p='[{"op": "replace", "path": "/spec/partitions", "value": 5}]'

# strimzi cruise control - rebalance whole cluster
kubectl apply -f - <<EOF
apiVersion: kafka.strimzi.io/v1beta2
kind: KafkaRebalance
metadata:
  name: kafka-cluster-rebalance
  namespace: kafka
  labels:
    strimzi.io/cluster: kafka-cluster
spec:
  mode: "full"
EOF

# approve the rebalance operation
kubectl annotate kafkarebalance kafka-cluster-rebalance -n kafka \
  strimzi.io/rebalance=approve
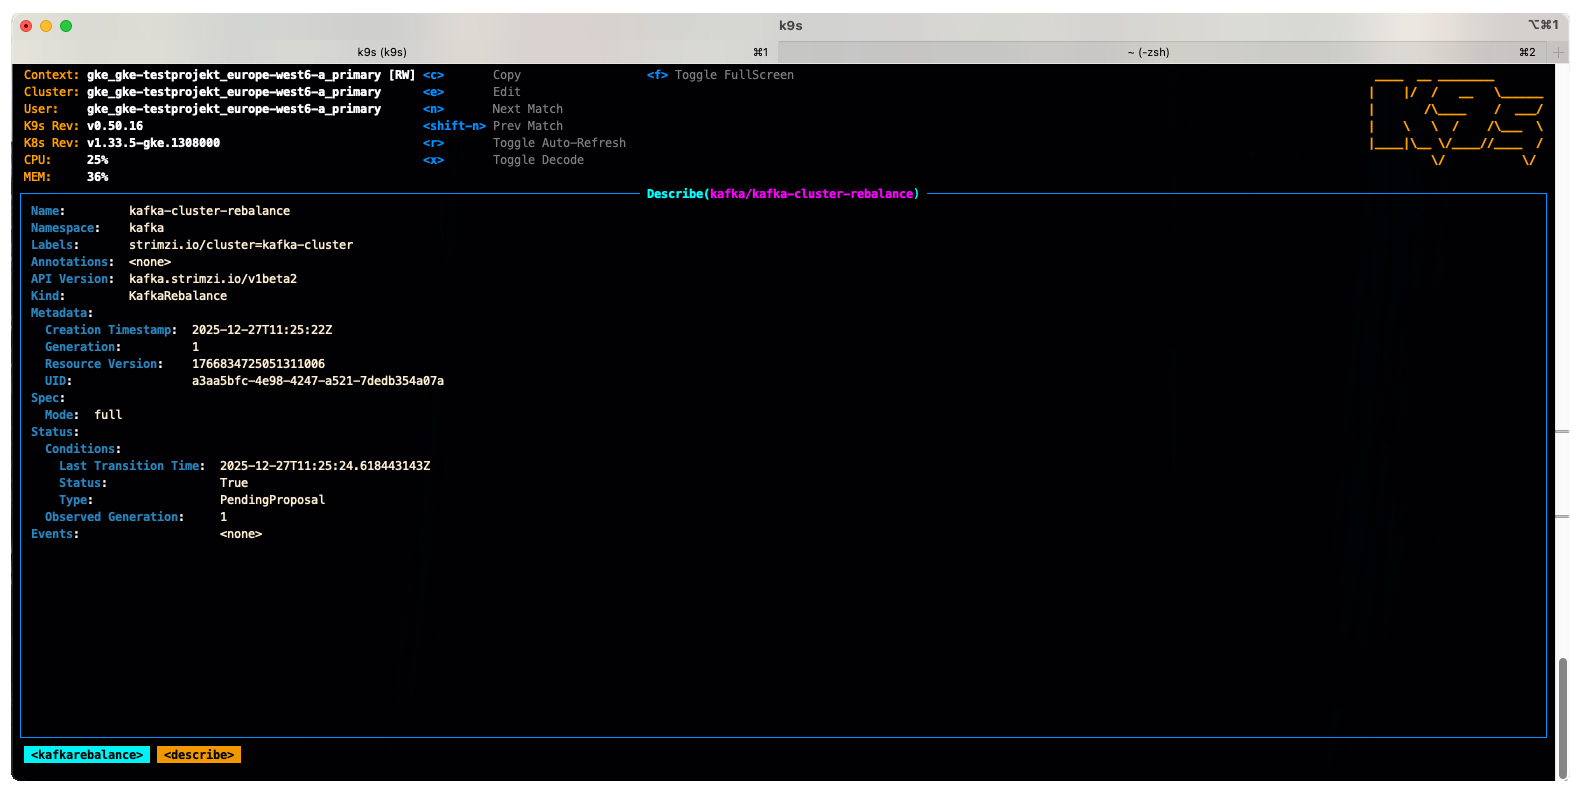
Nachdem ich Strimzi Cruise Control etwas Zeit gegeben hatte, den Rebalancing-Vorschlag zu erzeugen und anzuwenden, lief alles wie am Schnürchen.
Nach ein paar kleinen Anpassungen (dem Freigeben des Optimierungsvorschlags über die Ressource KafkaRebalance) sind die Partitionen jetzt gleichmässig verteilt: Die 5 Partitionen unseres Test-Topics liegen auf den 5 Brokern, jede mit 2 In-Sync-Replicas (insgesamt also Replikationsfaktor 3). Der Cluster meldet keine unterreplizierten Partitionen, und alle Komponenten sind gesund.
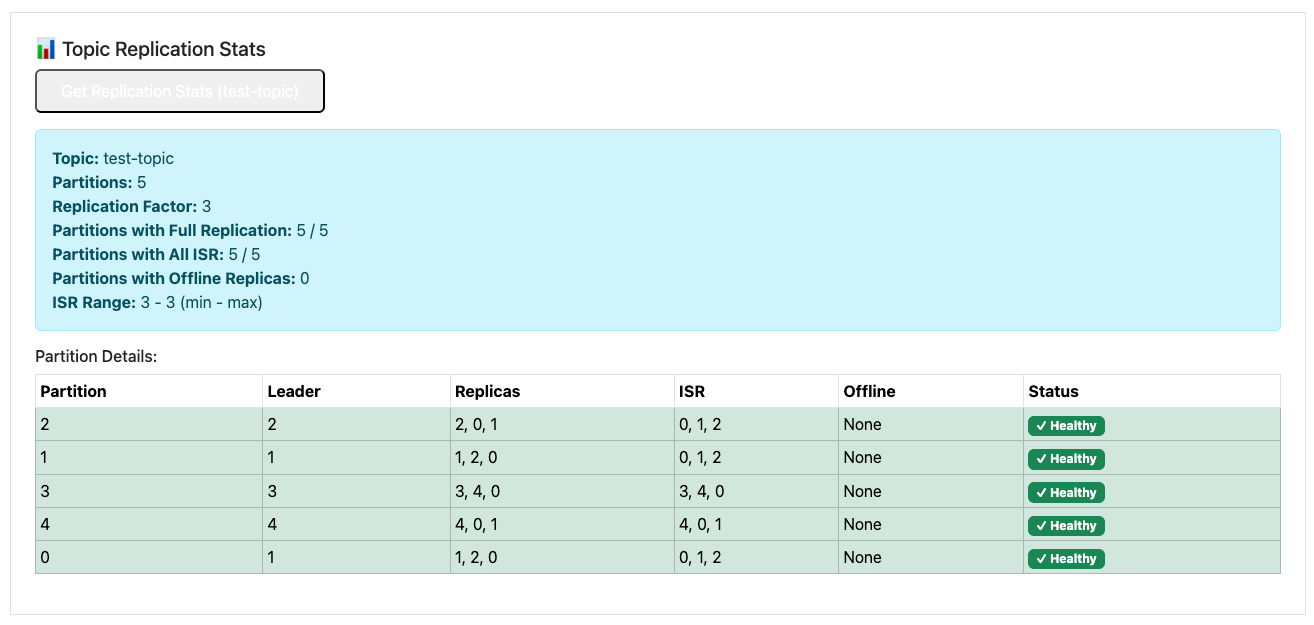
Das war ein voller Erfolg. Jetzt skalieren wir wieder herunter, von 5 auf 3 Broker.
Zuerst führe ich ein Rebalancing durch und entferne die Broker 3 und 4.
# rebalance with strimzi cruise control from 5 to 3 brokers
kubectl apply -f - <<EOF
apiVersion: kafka.strimzi.io/v1beta2
kind: KafkaRebalance
metadata:
  name: kafka-cluster-remove-brokers
  namespace: kafka
  labels:
    strimzi.io/cluster: kafka-cluster
spec:
  mode: "remove-brokers"
  brokers: [3, 4]
EOF

# approve rebalance
kubectl annotate kafkarebalance kafka-cluster-remove-brokers -n kafka \
  strimzi.io/rebalance=approve
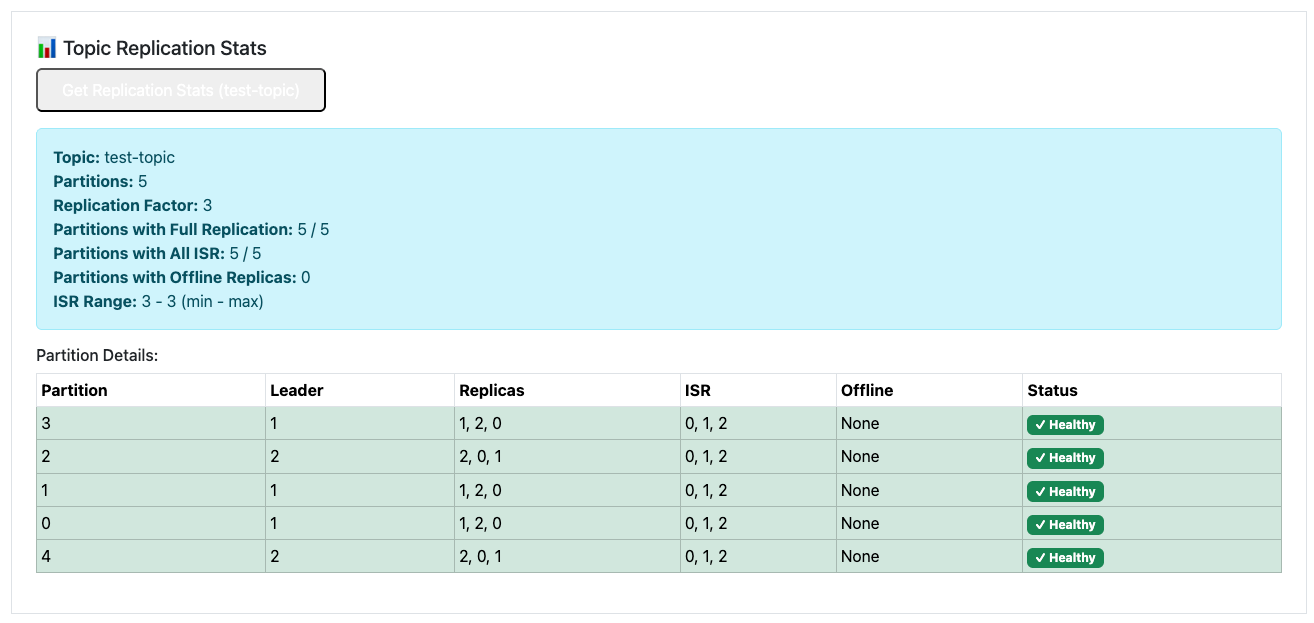
Nach kurzer Zeit hatte Cruise Control seine Arbeit erledigt, und unsere 5 Partitionen verteilen sich nur noch auf 3 Broker. Den langweiligen Teil, den Node-Pool wieder herunterzuskalieren, erspare ich Ihnen.
Fazit
Mit diesem Teil haben wir die meisten Ziele dieser Kafka-Blogserie erreicht: Wir haben einen skalierbaren, sicheren und produktionsreifen Apache-Kafka-Cluster auf Google Kubernetes Engine (GKE) deployt, einem echten, vom Hyperscaler verwalteten Kubernetes-Dienst.
Mit Strimzi haben wir die Stärken von Kubernetes-Operatoren genutzt, um einen modernen, KRaft-basierten Cluster zu betreiben: mit automatischer Skalierung, Cruise Control für intelligentes Rebalancing und nativer Integration für Sicherheit und Hochverfügbarkeit.
Rückblickend habe ich in Teil 4 zunächst die Kafka-Images von Confluent verwendet und bin dabei auf Hürden gestossen: Bestimmte Enterprise-Funktionen (etwa die Keycloak-/OAuth-Integration) erforderten, dass ich von Strimzi bereitgestellte Java-Bibliotheken von Hand ins Image einbaute, weil sie in der Open-Source-Distribution von Confluent nicht frei verfügbar sind.
Deshalb bin ich für diese Serie ganz auf Strimzi umgestiegen: Es bietet eine sauberere, nativere Kubernetes-Erfahrung ohne solche Workarounds.
Eine aktuelle Einschränkung: Strimzi bringt keine eingebaute Schema Registry mit. In einem möglichen Teil 6 möchte ich Observability ergänzen (Prometheus-/Grafana-Metriken, Tracing), Optionen für eine Schema Registry untersuchen, etwa die von Confluent oder Apicurio Registry, und die Kompatibilität mit unserem OAuth-basierten Autorisierungs-Setup testen. Wir werden sehen, ob die Integration glatt läuft oder zusätzliche Konfiguration braucht!
Danke, dass Sie dabei waren. Teilen Sie Ihre Erfahrungen mit Strimzi auf GKE gerne in den Kommentaren, besonders rund um Schema-Management oder fortgeschrittene Sicherheitsfunktionen.