Kafka in Produktion: von null zum Profi (Teil 1)


Kafka in Produktion – wir bauen einen skalierbaren, sicheren und Enterprise-tauglichen Message Bus auf der Google Cloud Platform
opensight.ch - roman hüsler
Inhaltsverzeichnis
- Teil 1 – Kafka-Einzelinstanz mit Docker
- Teil 2 – Kafka-Einzelinstanz mit Authentifizierung (SASL)
- Teil 3 – Kafka-Cluster mit TLS-Authentifizierung und ACLs
- Teil 4 – Enterprise-Authentifizierung und Zugriffskontrolle (OAuth 2.0)
- Teil 5 – Produktiver Kafka-Cluster auf Google Cloud mit Strimzi
- Teil 6 – Observability und Data Governance mit Strimzi (folgt)
TL;DR
Ich empfehle zwar, die Blogposts zu lesen, aber ich weiss, dass manche direkt zur «Single Source of Truth» springen: zum Code. Das ist ungefähr so, wie an einem Freitag ungetestet zu deployen.
Bitte sehr:
Einführung
Apache Kafka ist eine leistungsfähige Event-Streaming-Plattform, doch der Betrieb in Produktion ist eine ganz andere Herausforderung. Wir beginnen mit den Grundlagen, aber das hier ist kein Spielplatz: Schritt für Schritt bauen wir einen Message Bus in Enterprise-Qualität, der Hochverfügbarkeit, Sicherheit und Skalierbarkeit für echte Workloads bietet.
Ich bin selbst kein Kafka-Spezialist, ich lerne unterwegs. Wie so oft bei den opensight-Blogs können Sie mich auf meinem Weg von null zum Profi begleiten.
In dieser Blogserie gehen wir mit Kafka über die Grundlagen hinaus. Wir entwerfen ein produktionsreifes Kafka-Cluster-Deployment, das folgende Eigenschaften hat:
- Skalierbar – bewältigt wachsende Last ohne Performance-Engpässe.
- Sicher – setzt Authentifizierung (Plain, SCRAM, OAUTH), Autorisierung (ACL, OAUTH) und Verschlüsselung (TLS) durch.
- Sauber strukturiert – inklusive Schema Registry für eine ordentliche Data Governance.
- Enterprise-tauglich – mit den Funktionen, die eine ereignisgesteuerte Architektur in einer grossen Umgebung braucht.
Von Deployment-Strategien über Tuning und Monitoring bis zu Best Practices behandeln wir alles, was es braucht, um Kafka richtig in Produktion zu betreiben. Bauen wir ein Messaging-Rückgrat, das auf Dauer trägt.
Wir beginnen mit einer Einzelinstanz auf einer Docker-VM und arbeiten uns bis zu einem vollwertigen Deployment auf Google Kubernetes Engine (GKE) vor. Wir starten also mit den Grundlagen und ergänzen nach und nach Skalierbarkeit, Sicherheit und Enterprise-Funktionen. Die Details mögen sich unterwegs noch ändern, aber dieses strukturierte Vorgehen sorgt für ein solides Fundament und einen klaren Weg zu einer robusten Kafka-Infrastruktur.
Technologien und Vorkenntnisse
In dieser Serie konzentrieren wir uns auf das Deployment einer produktionsreifen Kafka-Infrastruktur, nicht auf die Kafka-Grundlagen. Damit Sie den grössten Nutzen aus dieser Anleitung ziehen, sollten Sie mit den folgenden Technologien gut vertraut sein:
- Linux – grundlegende Systemadministration und sicherer Umgang mit der Kommandozeile
- Kafka – Kernkonzepte wie Topics, Partitionen, Producer, Consumer und Broker
- Docker – Containerisierung und Betrieb von Kafka in Containern
- Terraform / OpenTofu – Infrastructure as Code (IaC) zur Automatisierung von Deployments
- Kubernetes – Orchestrierung von Kafka-Clustern in einer Cloud-nativen Umgebung
- Google Cloud Platform (GCP) – Bereitstellung und Verwaltung von Ressourcen auf GCP
Wenn Sie sich mit diesen Technologien wohlfühlen, kann es losgehen!
Teil 1 – Kafka-Einzelinstanz mit Docker
Wir beginnen mit dem Deployment einer einzelnen Kafka-Instanz auf einer Docker-VM.
Voraussetzungen:
Für dieses Setup habe ich auf der Google Cloud Platform (GCP) eine Test-VM mit einer Ubuntu-Linux-Instanz (n1-standard-2) mit 2 vCPUs und 8 GB Arbeitsspeicher bereitgestellt. Sie müssen aber nicht zwingend GCP verwenden: Jede Ubuntu-basierte VM mit installiertem Docker funktioniert genauso gut.
Übersicht
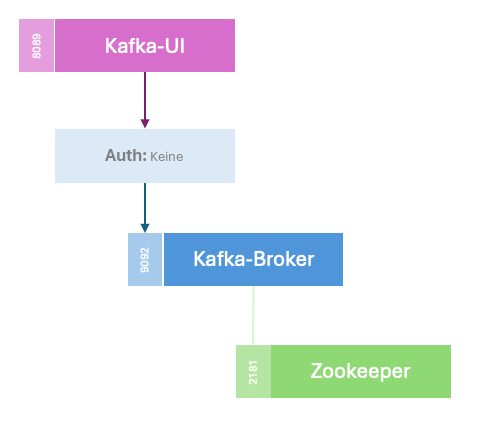
Zum Einstieg deployen wir einen einzelnen Kafka-Broker zusammen mit einer einzelnen ZooKeeper-Instanz auf unserem Docker-Host. In diesem Stadium konfigurieren wir weder Verschlüsselung noch Authentifizierung: Unser Hauptziel ist ein minimales, funktionierendes Kafka-Setup als Grundlage für die fortgeschritteneren Konfigurationen der nächsten Schritte.
Alle Deployment-Dateien finden Sie auf GitHub:
Seit dem Start dieses Blogs bin ich auf KIP-500: Replace ZooKeeper with a Self-Managed Metadata Quorum gestossen, das die Abhängigkeit von ZooKeeper in Apache Kafka beseitigen soll. Das ist eine wichtige Entwicklung, auf die wir in einem späteren Beitrag genauer eingehen.
listeners: PLAINTEXT://0.0.0.0:9092
Kafka lauscht im Plaintext-Modus auf allen Netzwerkschnittstellen, also ohne Authentifizierung und ohne Verschlüsselung. Die Option listeners legt fest, wo der Kafka-Broker eingehende Verbindungen annimmt, während advertised.listeners bestimmt, wie Kafka sich gegenüber Clients (Producern/Consumern) bekannt gibt.
Vorerst verwende ich das Docker-Image cp-kafka, weil es ein unkompliziertes Setup und ein schnelles Deployment ermöglicht. Die Konfiguration ist einfach, denn wichtige Optionen wie advertised.listeners lassen sich über Umgebungsvariablen wie KAFKA_ADVERTISED_LISTENERS setzen. Das Image schreibt diese Werte beim Start automatisch in die Kafka-Konfigurationsdatei, was das Setup deutlich vereinfacht.
version: "3.8"

services:
  zookeeper:
    image: "${ZOOKEEPER_IMAGE}"
    container_name: zookeeper
    environment:
      ZOOKEEPER_CLIENT_PORT: 2181
      ZOOKEEPER_TICK_TIME: 2000
    ports:
      - 2181:2181
    networks:
      - kafka

  kafka:
    image: "${KAFKA_IMAGE}"
    container_name: kafka
    depends_on:
      - zookeeper
    environment:
      KAFKA_BROKER_ID: 1
      KAFKA_ZOOKEEPER_CONNECT: zookeeper:2181
      KAFKA_LISTENER_SECURITY_PROTOCOL_MAP: PLAINTEXT:PLAINTEXT,PLAINTEXT_HOST:PLAINTEXT
      KAFKA_INTER_BROKER_LISTENER_NAME: PLAINTEXT
      KAFKA_LISTENERS: PLAINTEXT://0.0.0.0:9092
      KAFKA_ADVERTISED_LISTENERS: PLAINTEXT://kafka:9092
      KAFKA_AUTO_CREATE_TOPICS_ENABLE: "true"
      KAFKA_OFFSETS_TOPIC_REPLICATION_FACTOR: 1
      KAFKA_TRANSACTION_STATE_LOG_MIN_ISR: 1
      KAFKA_TRANSACTION_STATE_LOG_REPLICATION_FACTOR: 1
      KAFKA_GROUP_INITIAL_REBALANCE_DELAY_MS: 100
    ports:
      - 9092:9092
    networks:
      - kafka

  kafka-ui:
    image: "${KAFKA_UI_IMAGE}"
    container_name: kafka-ui
    depends_on:
      - kafka
    environment:
      KAFKA_CLUSTERS_0_NAME: local
      KAFKA_CLUSTERS_0_BOOTSTRAPSERVERS: kafka:9092
    ports:
      - 8089:8080
    networks:
      - kafka

networks:
  kafka:
    driver: bridge
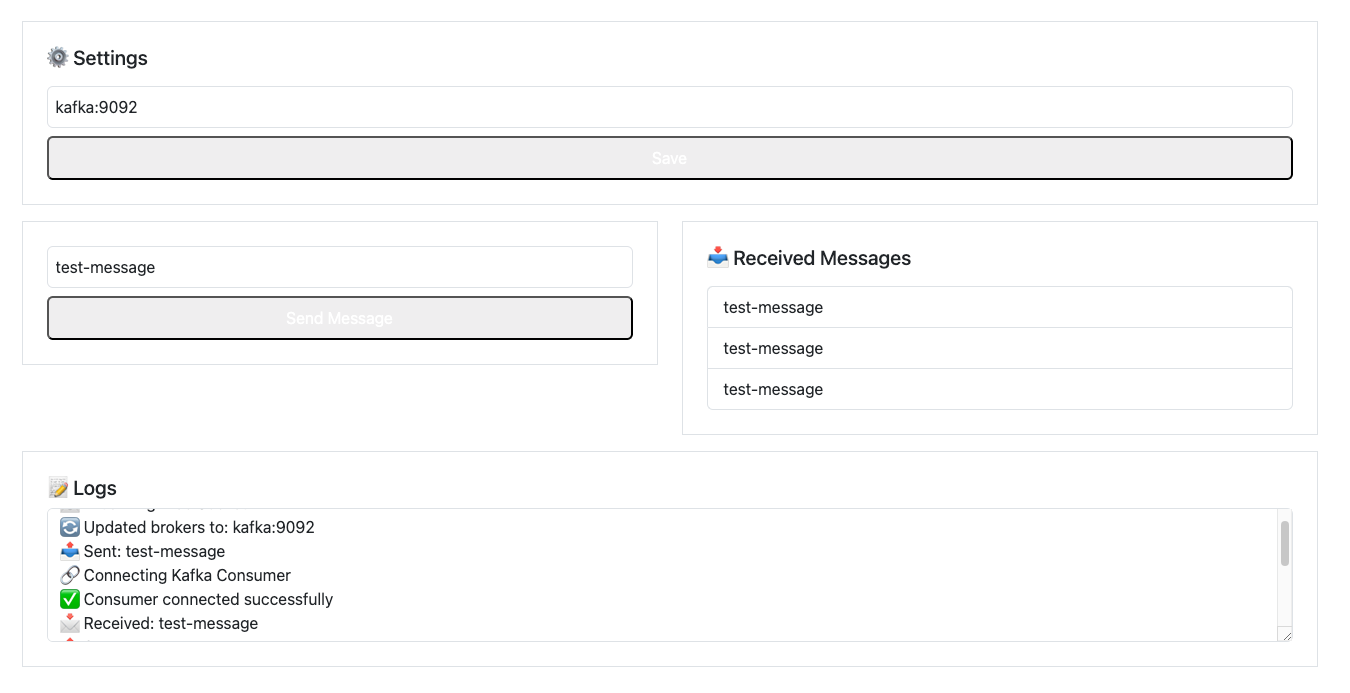
Jetzt provisionieren wir unser erstes Kafka-Deployment. Ich habe ausserdem ein kleines Testprogramm in NextJS geschrieben, mit dem ich dieses und die weiteren Kafka-Deployments testen kann. Es kann eine Nachricht auf den Bus publizieren (links) und Nachrichten empfangen (rechts). Das einfache Kafka-Deployment scheint einwandfrei zu funktionieren.
docker compose up -dKafka auf dem Docker-Host deployen
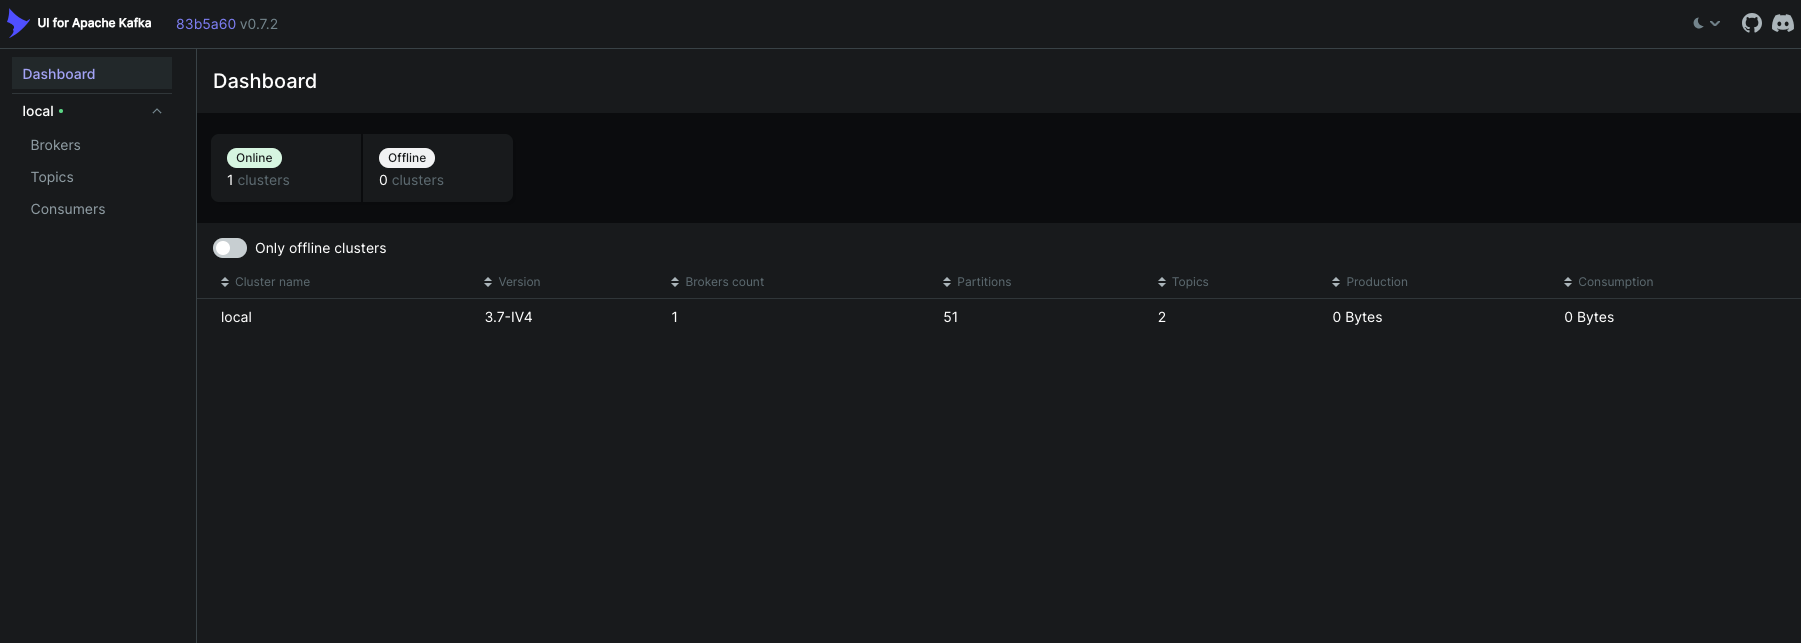
Die Kafka UI ist auf dem Host über Port 8089 erreichbar. Ich empfehle Ihnen, die Kafka UI an dieser Stelle zu erkunden und sich mit ihren Funktionen vertraut zu machen. Legen Sie Topics an, publizieren Sie Nachrichten und beobachten Sie, wie Kafka sie in Echtzeit verarbeitet. Dieser praktische Zugang hilft, die Funktionsweise von Kafka besser zu verstehen. 🚀
Wenn Sie mit dem Experimentieren fertig sind, können Sie das Kafka-Deployment über das Makefile oder direkt mit einem Docker-Compose-Befehl wieder abbauen. So werden alle zugehörigen Container und Volumes sauber entfernt.
docker compose down

or

make clean
Kafka-Deployment abbauen
Damit ist der erste Teil dieser Blogserie abgeschlossen. Im nächsten Teil bleiben wir bei einer Einzelinstanz, führen aber SASL (Simple Authentication and Security Layer) für die Authentifizierung ein. Bleiben Sie dran!